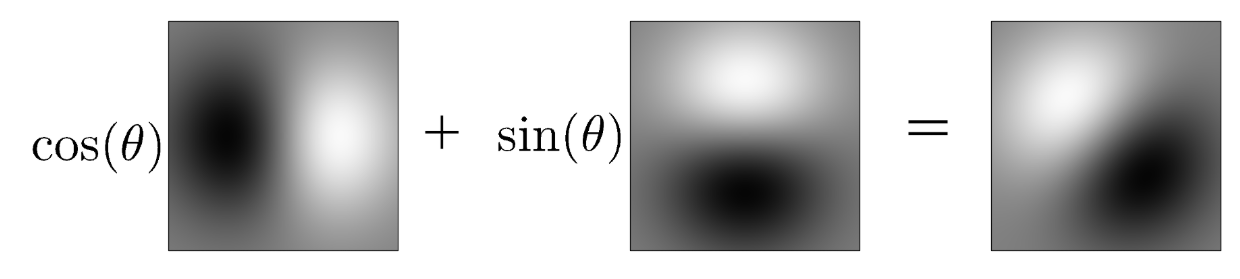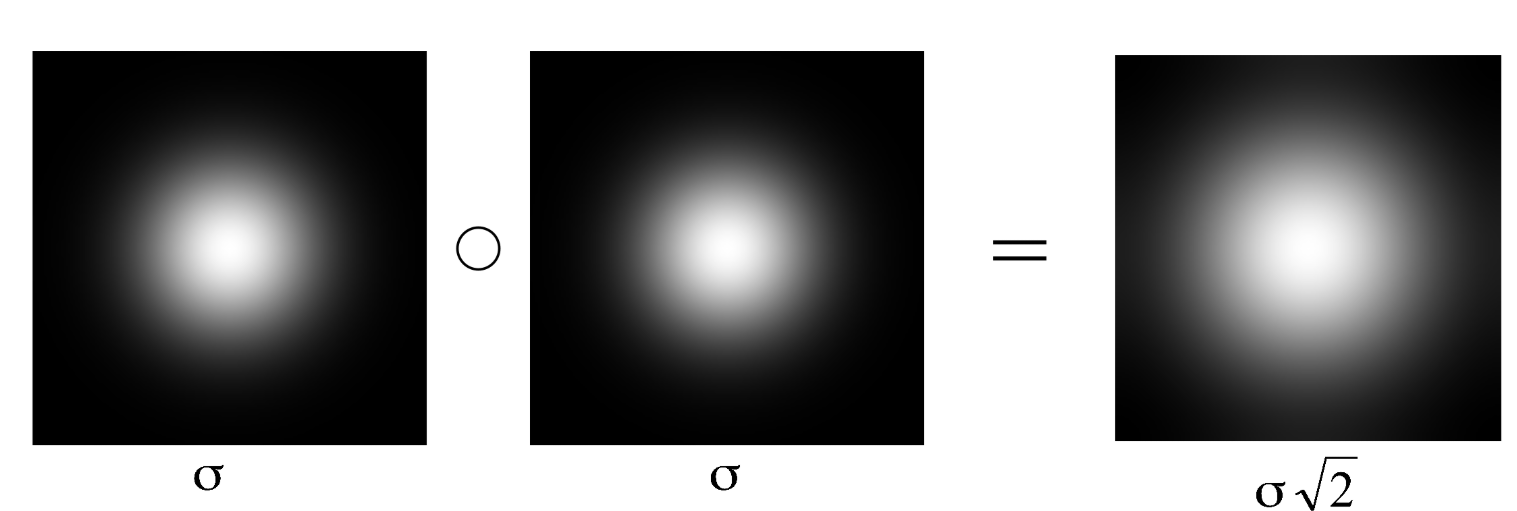cs / computer-vision

Computer Vision overview

cv 的常见用处:

  • object detection
  • 3D reconstruction (from RGB images) and modeling
  • robot vision

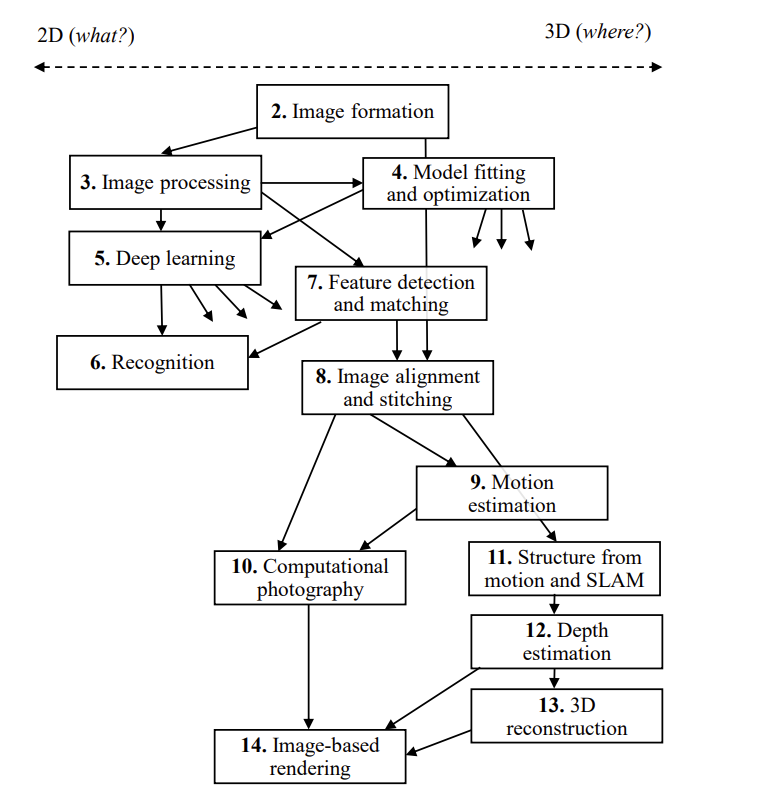
学习路径:

image-20250910211434734

[^1]: picture credit: https://szeliski.org/Book/, page 23.

Image processing

image as a signal

图像是信号的一种.

  • 一维离散信号:

    • 音频、时间序列

      是 y:Z→Ry : \mathbb{Z} \to \mathbb{R} 的函数

      更 compact 的形式是 $y:Zlength→R y:\mathbb{Z}_{\text{length}} \to \mathbb{R} 等同于一个 等同于一个 \mathbb{R}^{\text{length}}$ 的 vector.

  • 二维离散信号:

    • 图像(灰度)

      是 I:Z2→RI : \mathbb{Z}^2 \to \mathbb{R} 的函数

      更准确而言是 $I:Zpixels(hori)×Zpixels(verti)→[0,255] I: \mathbb{Z}_{\text{pixels(hori)}}\times \mathbb{Z}_{\text{pixels(verti)}} \to [0,255] 等同于一个 等同于一个 \mathbb{R}^{\text{pixels}(\text{hori})} \times \mathbb{R}^{\text{pixels}(\text{verti})}的矩阵,其元素值取自 的矩阵, 其元素值取自 [0,255]$

    • 图像(RGB)

      是 I:Z2→R3I : \mathbb{Z}^2 \to \mathbb{R}^3 的函数

      更准确而言是 $I:Zpixels(hori)×Zpixels(verti)→[0,255]3I(m,n)=(R(m,n),G(m,n),B(m,n)) I: \mathbb{Z}_{\text{pixels(hori)}}\times \mathbb{Z}_{\text{pixels(verti)}} \to [0,255]^3 \\ I(m,n)=(R(m,n),G(m,n),B(m,n)) $

      也等同于一个 (R3)pixels(hori)×(R3)pixels(verti)(\mathbb{R}^3)^{\text{pixels}(\text{hori})} \times (\mathbb{R}^3)^{\text{pixels}(\text{verti})} 的矩阵, 其元素值取自 [0,255]3[0,255]^3

  • 三维离散信号:

    • 视频(空间 + 时间, 灰度)

    • 3D 模型(灰度)

      都是 V:Z3→RV : \mathbb{Z}^3 \to \mathbb{R} 或者 V:Z3→R3V : \mathbb{Z}^3 \to \mathbb{R}^3 的函数

所以图像是信号处理里的一个特殊例子.

convolution and neighborhood filtering

linear filter 就是一个线性算子 HH, 作用在输入信号 gg 上. $f=H(g) f = H(g) 假设输入信号 假设输入信号 g\in \mathbb{R}^N,而输出信号, 而输出信号 f \in \mathbb{R}^M,那么, 那么 H=(H[n,k])=[H[0,0]H[0,1]⋯H[0,N−1]H[1,0]H[1,1]⋯H[1,N−1]⋮⋮⋱⋮H[M−1,0]H[M−1,1]⋯H[M−1,N−1]]∈RM×N H = (H[n,k]) = \begin{bmatrix} H[0,0] & H[0,1] & \cdots & H[0,N-1] \\ H[1,0] & H[1,1] & \cdots & H[1,N-1] \\ \vdots & \vdots & \ddots & \vdots \\ H[M-1,0] & H[M-1,1] & \cdots & H[M-1,N-1] \end{bmatrix} \in \mathbb{R}^{M \times N} 这里每个 这里每个 h[n,k]就是矩阵第 就是矩阵第 n行、第 行、第 k$ 列的元素.

对 一维信号, linear filter 即: $f[n]=∑k=−∞∞H[n,k] g[k] f[n] = \sum_{k=-\infty}^{\infty} H[n, k] \, g[k] $

  • g[k]g[k] 是输入
  • f[n]f[n] 是输出

对 二维图像, linear filter 即: $f[m,n]=∑i∑jH[m,n;i,j] g[i,j] f[m,n] = \sum_{i}\sum_{j} H[m,n; i,j] \, g[i,j] $

  • g[i,j]g[i,j] 是输入矩阵
  • f[m,n]f[m,n] 是输出矩阵

convolution

对于一个 linear filter HH, 如果 diagonal 上的所有元素都是相同的(未必是 block matrix): $H=[h[0]00⋯0h[1]h[0]0⋯0h[2]h[1]h[0]⋯0⋮⋮⋮⋱⋮h[K−1]h[K−2]h[K−3]⋯h[0]0h[K−1]h[K−2]⋯h[1]00h[K−1]⋯h[2]⋮⋮⋮⋱⋮]. H = \begin{bmatrix} h[0] & 0 & 0 & \cdots & 0 \\ h[1] & h[0] & 0 & \cdots & 0 \\ h[2] & h[1] & h[0] & \cdots & 0 \\ \vdots & \vdots & \vdots & \ddots & \vdots \\ h[K-1] & h[K-2] & h[K-3] & \cdots & h[0] \\ 0 & h[K-1] & h[K-2] & \cdots & h[1] \\ 0 & 0 & h[K-1] & \cdots & h[2] \\ \vdots & \vdots & \vdots & \ddots & \vdots \end{bmatrix}. 我们知道这个叫做Toeplitz结构.一言概括即: 我们知道这个叫做 Toeplitz 结构. 一言概括即: H[n,k]=h[n−k] H[n,k] = h[n-k] $ 那么则称之为一个 convolution.

ex: 1D 和 2D 图像的 convolution

  • f[n]=∑kH[n,k] g[k]=∑kh[k] g[n−k]=∑kh[n−k] g[n]f[n] = \sum_{k} H[n, k] \, g[k] = \sum_{k} h[k] \, g[n-k] = \sum_{k} h[n-k] \, g[n]
  • f[m,n]=∑i∑jh[m,n;i,j] g[i,j]=∑i∑jh[i,j] g[m−i,n−j]=∑i∑jh[m−i,n−j] g[m,n]\begin{align} f[m,n] &= \sum_{i}\sum_{j} h[m,n; i,j] \, g[i,j] \\ &=\sum_{i}\sum_{j} h[i,j] \, g[m-i, n-j]\\ &= \sum_{i}\sum_{j} h[m-i,n-j] \, g[m, n] \end{align}

我们学过 analysis 就知道它的连续形式是:

f(t)=∫h(τ) g(t−τ) dτ=∫h(t−τ) g(τ) dτf(t) = \int h(\tau)\, g(t-\tau)\, d\tau = \int h(t-\tau)\, g(\tau)\, d\tau

我们可以 denote 这个操作为: [ f = (h * g) ]

convolution (与 cross-correlation) 的几何理解

convolution 的几何理解: Toeplitz 结构的每条对角线上的元素相同, 即

  • 每一行就是在上一行的基础上整体平移一格.
  • 所以当 HH 作用在信号 gg 上时, 输出 ff 的模式和 gg 的平移保持一致.

因而几何意义就是: 当把输入图像整体往右 / 往下挪一个像素, 输出结果也会整体挪相同的像素.

因而它相当于:有一个 “convolution kernel”, 在整张图像上是以同样的方式滑动, 不会因为位置不同而改变规则. 称之为 translation-invariance.

容易发现, 对于 convolution matrix HH, 它对于 input gg 的作用 $f=Hg f =Hg $ 就等同于用一个小 matrix (即 “convolution kernel” 倒过来) 扫过整个 g, 在扫过 input 每个元素时都用这个 matrix 与 input 中这个元素为中心的区域来和倒过来的 kernel 做加权和运算.

  • 更简洁而言: 每个输出像素 = kernel 和对应输入邻域 patch 的 dot product;

这个运算如果去掉 “kernel 倒过来” 这一部分, 称为 cross-correlation (互相关) $(f⋆g)(t)=∫−∞∞f∗(τ) g(t+τ) dτ (f \star g)(t) = \int_{-\infty}^{\infty} f^*(\tau)\, g(t+\tau)\, d\tau 而如果加上“kernel倒过来”这一步则变成了我们现在所说的卷积: 而如果加上 “kernel 倒过来” 这一步则变成了我们现在所说的卷积: (f∗g)(t)=∫−∞∞f(τ) g(t−τ) dτ. (f * g)(t) = \int_{-\infty}^{\infty} f(\tau)\, g(t-\tau)\, d\tau. $

linear filtering with filter kernel: 即 convolution.

我们可以使用不同的 convolution kernel 来进行不同形式 linear filtering.

定义: 使用 convolution kernel 进行 filter 的 linear filtering 就叫做 neighborhood filtering.

neighboring filters (i.e. convolution with a kernel)

ex1: average filter (denoising)

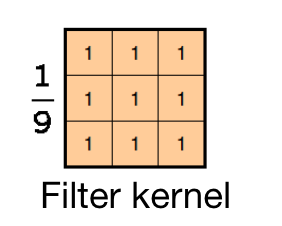
形式:所有权重相等的均值核, 比如 3×33\times 3 的 191\tfrac{1}{9}\mathbf{1}.

我们用 convolution kernel Screenshot 2025-09-11 at 16.46.19 来扫过下面的 input gg 的第一第二个元素 (附近的 kernel 形状), 得到 output 的第一第二个元素:

![Screenshot 2025-09-11 at 16.24.40](assets/Screenshot 2025-09-11 at 16.24.40.png)

这里, 输入和输出 (左列和上行是 padding) 都是 6*6 matrix, 即 f,g∈R6×6f,g\in\mathbb{R}^{6\times6}, 而把它们 flatten 后则得到

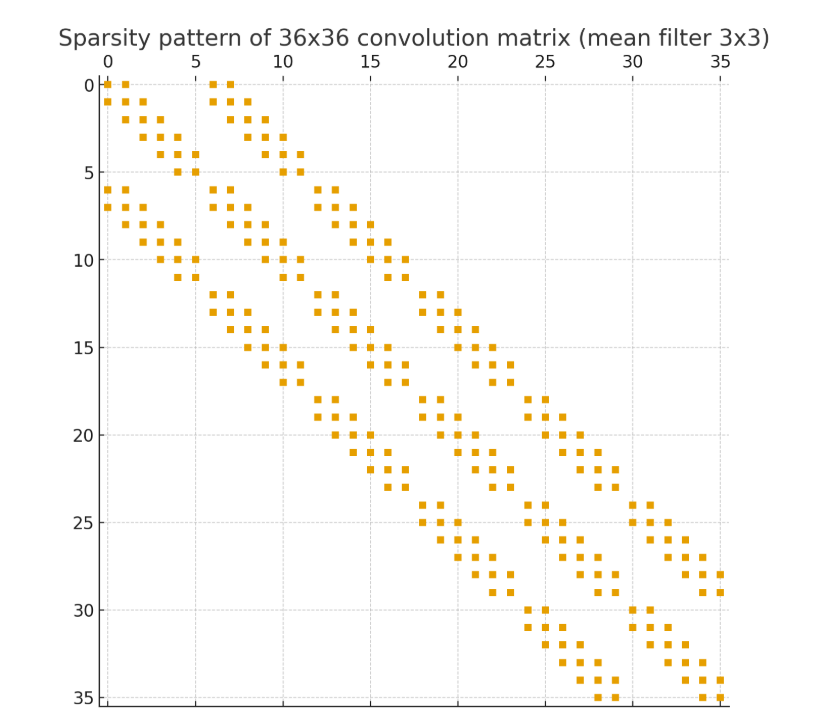
这个 3×33\times3 convolution kernel 的完整 convolution matrix 是: H∈R36×R36H \in \mathbb{R}^{36} \times \mathbb{R}^{36}, 每一行在对应的 3×33 \times 3 邻域位置放上 1/91/9, 其余位置是 0, 即每行只有 9 个非零元素 (1/9).

画出来就是:
Screenshot 2025-09-11 at 16.58.38

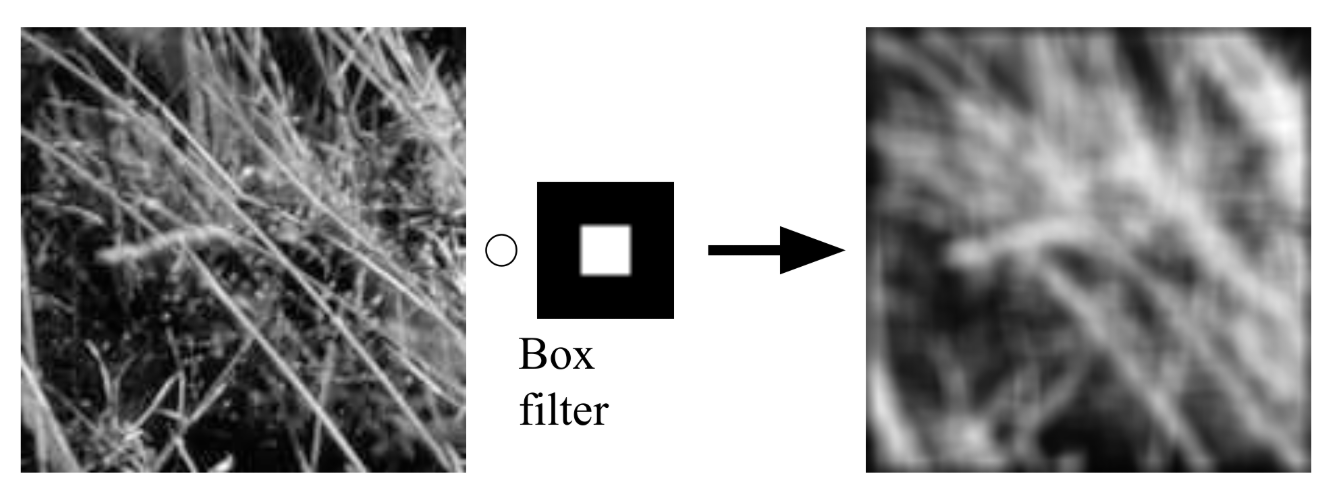
用途:图像去噪 (denoising)、模糊 (blur), 通过邻域平均来抑制噪声, 但也会模糊边缘

![Screenshot 2025-09-11 at 17.17.47](assets/Screenshot 2025-09-11 at 17.17.47.png)

我们可以用 average filter 来从 noisy image 复原 original image.

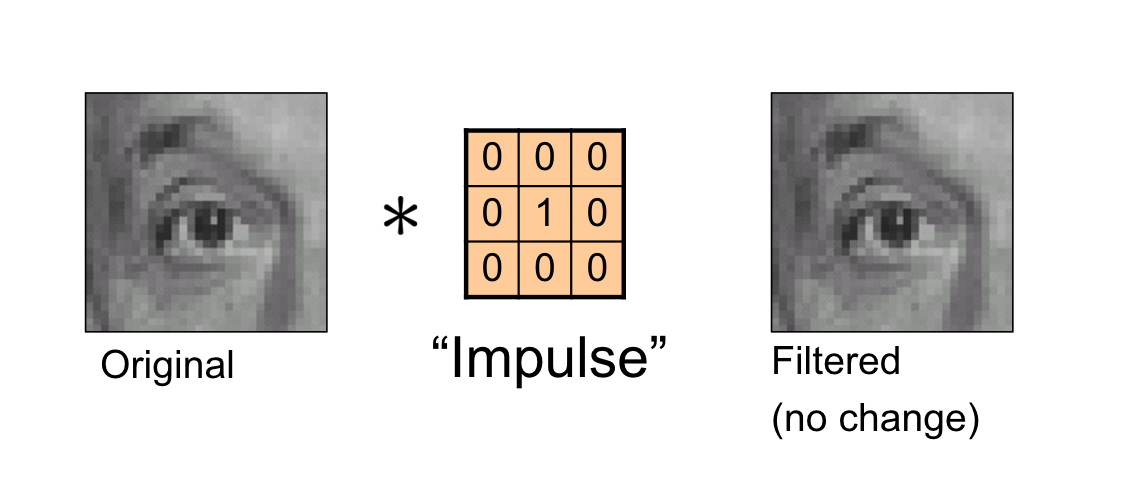
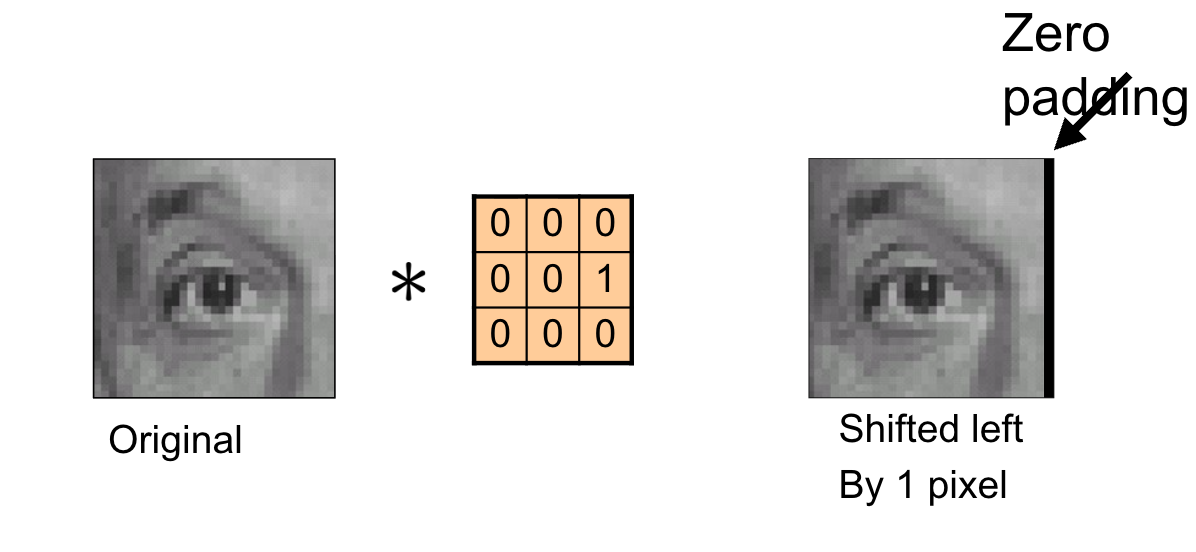
ex2: impulse filter

  • 形式:一个像素为 1, 其余为 0.
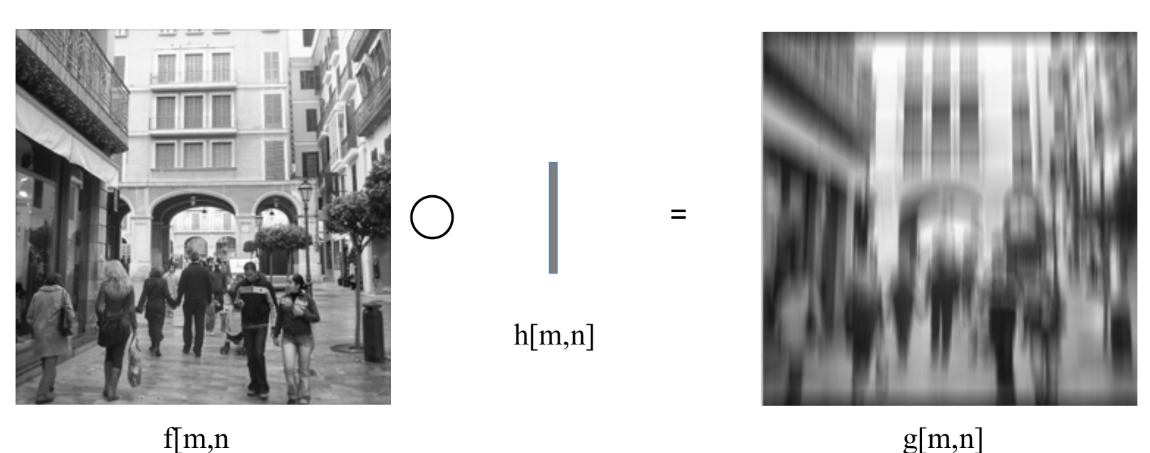
  • 用途:保持图像不变, 进行平移.
Screenshot 2025-09-11 at 17.20.31 Screenshot 2025-09-11 at 17.20.07

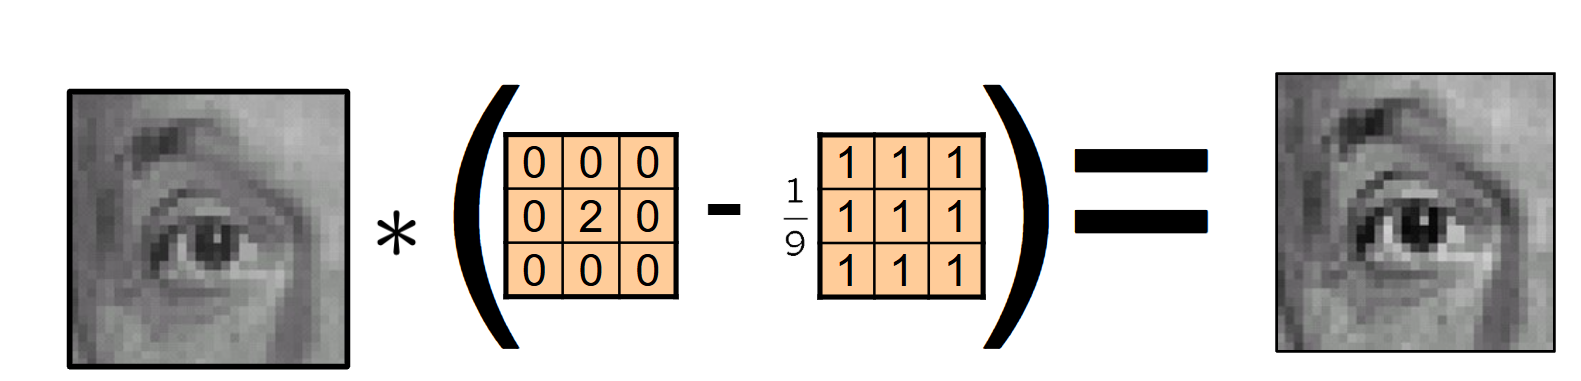
ex3: sharpening filter

image-20250911191633623

ex: $[000020000]  −  19[111111111] \begin{bmatrix} 0 & 0 & 0 \\ 0 & 2 & 0 \\ 0 & 0 & 0 \end{bmatrix} \;-\; \frac{1}{9}\begin{bmatrix} 1 & 1 & 1 \\ 1 & 1 & 1 \\ 1 & 1 & 1 \end{bmatrix} $ 强调像素和邻域平均值之间的差异, 从而增强边缘、增加清晰度

ex4: derivative filters (edge detection)

remember, 一个 image 其实是一个函数:
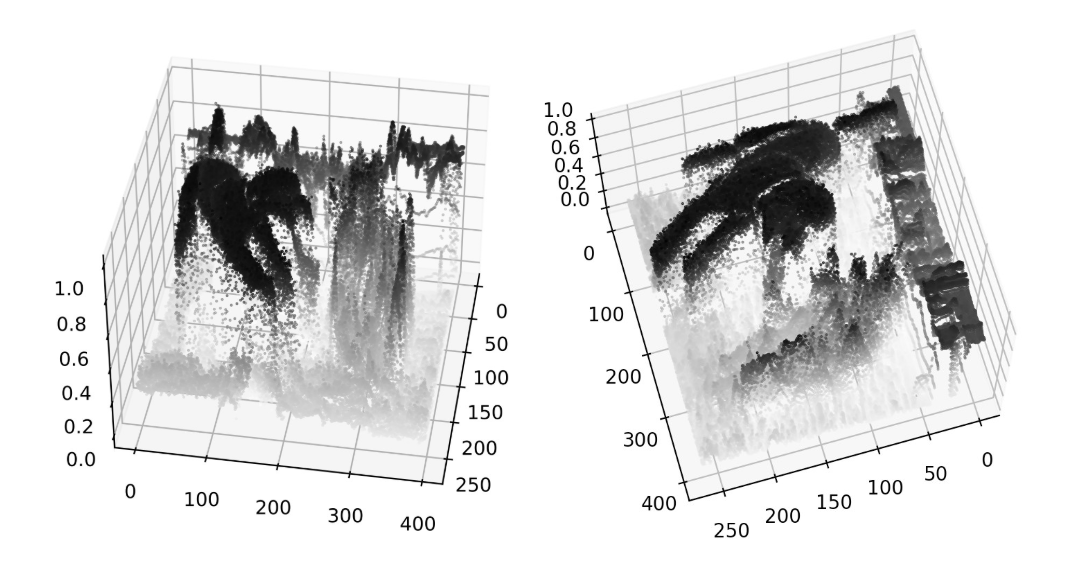
image-20250911192146592

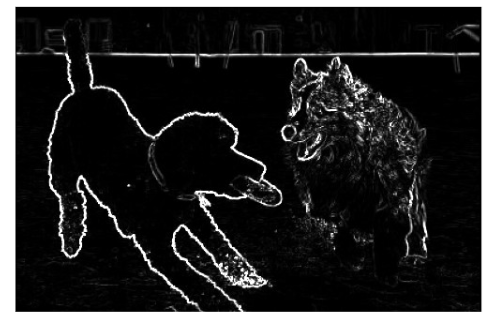
因而它梯度大的地方就是它的边缘.

这个函数在分析的定义上来看是一个 piecewise const 函数, 在网格内 const, 在网格线上 jump discontinuous, 如果把它看作 R2→R\mathbb{R}^2 \to \mathbb{R} 的话,

但是我们可以用两个网格之间的 intensity 变化来数值近似梯度(即有限差分)

  • 水平梯度 $∂I∂x≈I(x,y)−I(x−1,y) \frac{\partial \mathbf{I}}{\partial x} \approx \mathbf{I}(x, y)-\mathbf{I}(x-1, y) 数值近似: 数值近似: dx=[000−110000] d_x = \begin{bmatrix} 0 & 0 & 0 \\ -1 & 1 & 0 \\ 0 & 0 & 0 \end{bmatrix} $

  • 垂直梯度

    类似. 数值近似是: $dy=[0000100−10] d_y = \begin{bmatrix} 0 & 0 & 0 \\ 0 & 1 & 0 \\ 0 & -1 & 0 \end{bmatrix} $

这里是向后差分, 当然也可以中心差分: $∂I∂x(x,y)≈I(x+1,y)−I(x−1,y)2 \frac{\partial \mathbf{I}}{\partial x}(x, y) \approx \frac{\mathbf{I}(x+1, y)-\mathbf{I}(x-1, y)}{2} ![image−20250911193103695](./assets/image−20250911193103695.png) ![image-20250911193103695](./assets/image-20250911193103695.png)  Total edge strength: S=Ix2+Iy2 \text { Total edge strength: } S=I_x^2+I_y^2 $ image-20250911193236143

ex5: Gaussian filters (blurring, smoothing)

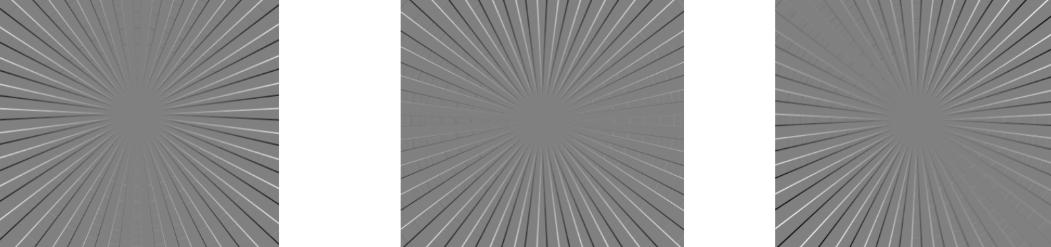
box 形状的 blurring 会让整个图都有一层方形的拉伸. 每个像素受到方形周边区域的影响.
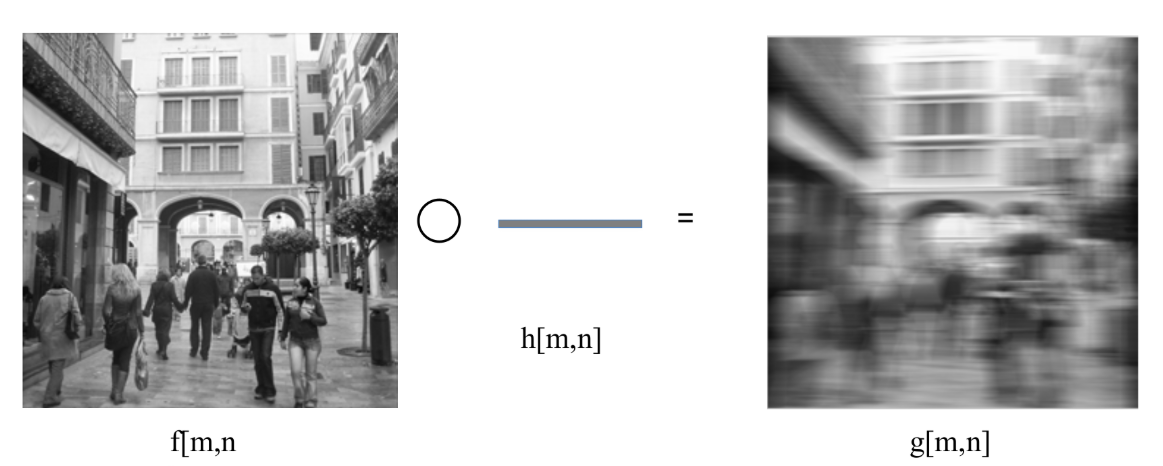
image-20250912111152196 image-20250912111204772 image-20250912111749147

[^]: Image source: D. Forsyth

我们更希望有一个这样的 kernel:
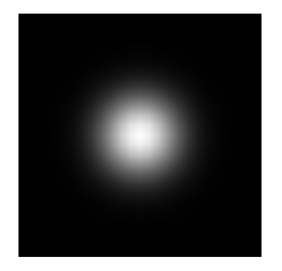
image-20250912111418860

于是我们自然想到使用高斯分布: $Gσ=12πσ2e−(x2+y2)2σ2 G_\sigma=\frac{1}{2 \pi \sigma^2} e^{-\frac{\left(x^2+y^2\right)}{2 \sigma^2}} $

  • Constant factor in front makes kernel sum to 1
  • Can estimate it by simply summing the values in the kernel
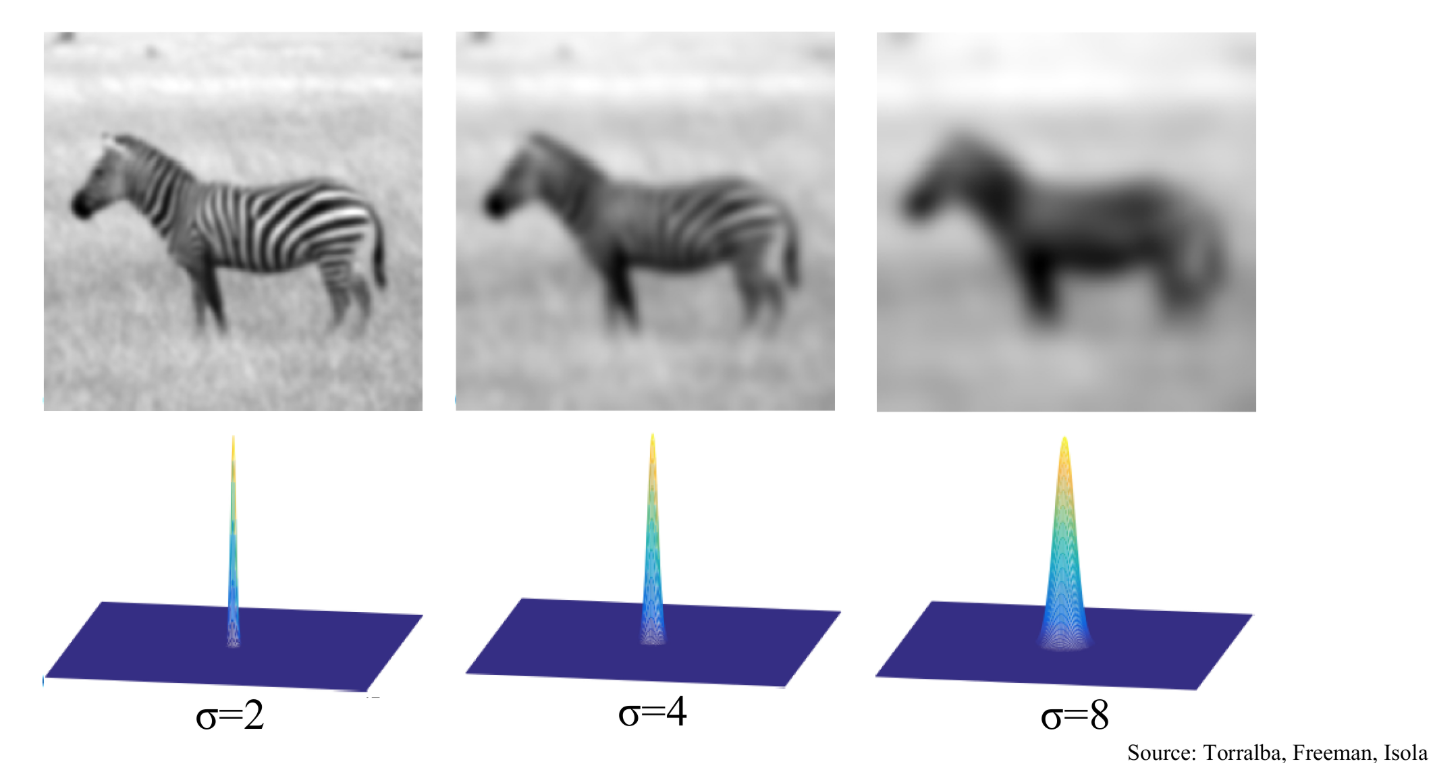
image-20250912111700286

more about Gaussian and gradient filters

properties of Gaussian filters

  • 性质 1: 一个 Gaussian filter 和另一个 Gaussian filter 的 convolution 仍然是一个 Gaussian filter.

    image-20250912112343335
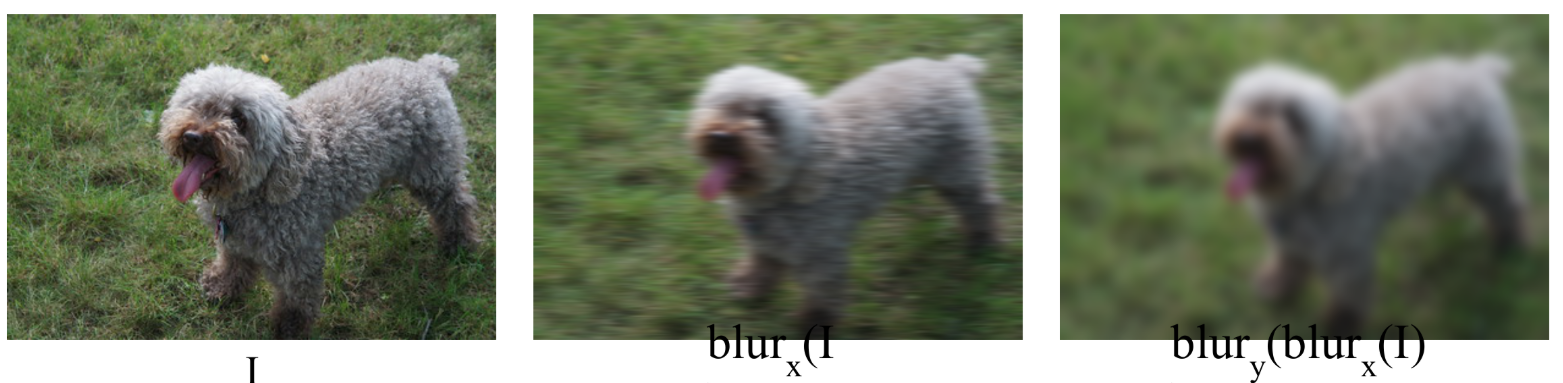
  • 性质 2: Gaussian filter 是 separable 的:

    • convolution with 2D Gaussian filter (n×nn\times n) 等于先后 convolution with 两个 1D Gaussian filters (n×1,1×nn\times 1, 1\times n)
    • 因而不论是多少维的 Gaussian filtering, 都可以直接可以把复杂度降低到 O(n)O(n).
    image-20250912112756019

combining Gaussian and derivative filters

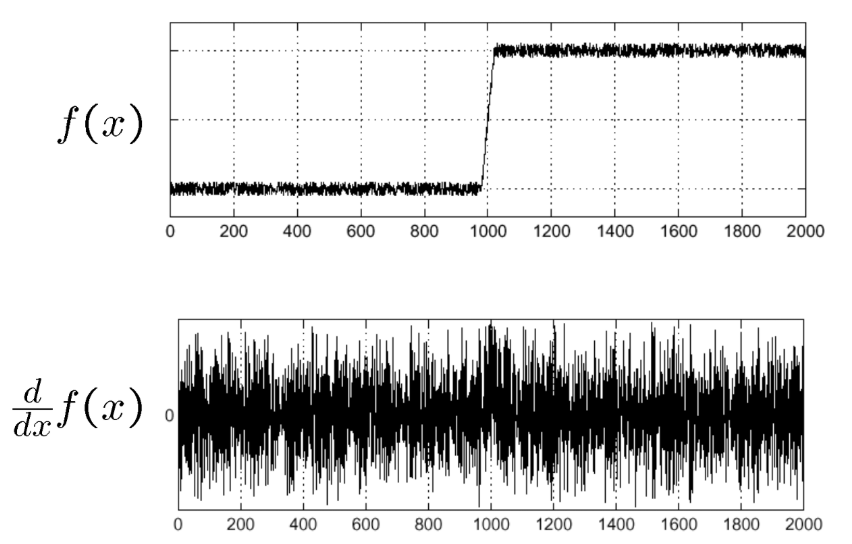
derivative filter 的问题是: 它对于很小的边缘也很敏感.
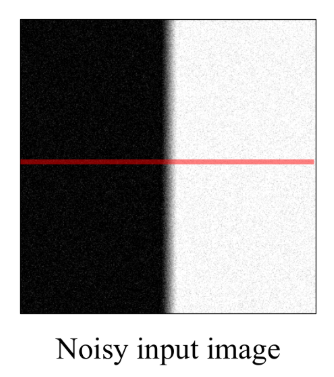
image-20250912113023391 image-20250912113033142

因而我们的解决方法是: 在差分求数值导前, 先 apply 一个 Gaussian filter 来 smoothing
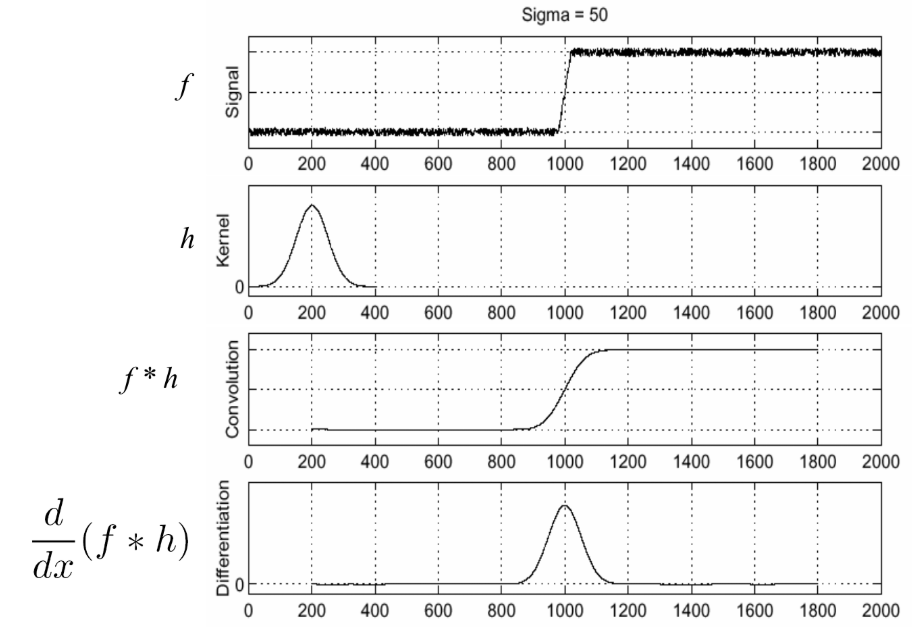
image-20250912113148536

[^2 ]: image source: S. Seitz

任意方向上的 gradient filters

我们如果想要特定方向上的 gradient filter:
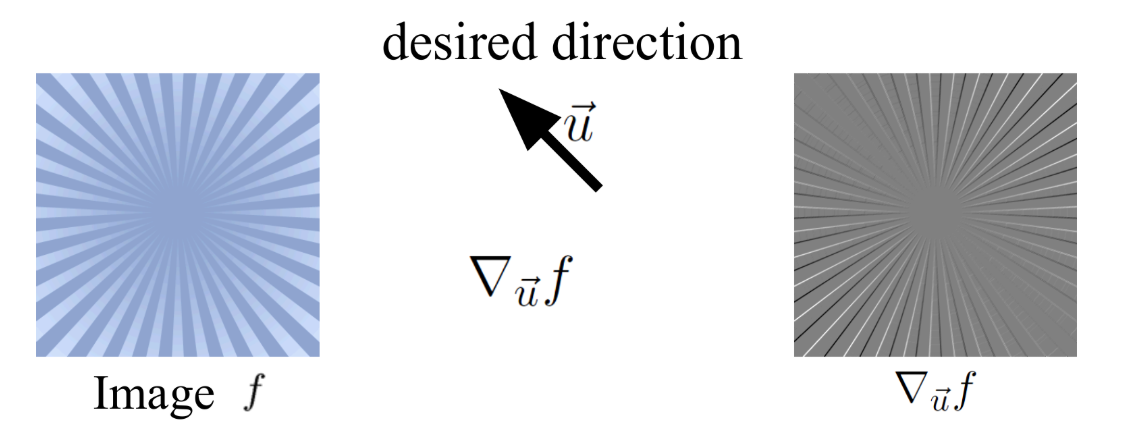
image-20250912115234586

我们可以使用 multivariable calculus fact: $∇u⃗f(x⃗)=∇f(x⃗)⋅u⃗ \nabla_{\vec{u}} f(\vec{x})=\nabla f(\vec{x}) \cdot \vec{u} 更具体: 更具体: ∂f∂x⋅ux+∂f∂y⋅uy=∇u⃗f \frac{\partial f}{\partial x} \cdot u_x + \frac{\partial f}{\partial y} \cdot u_y = \nabla_{\vec{u}} f $ image-20250912115811001

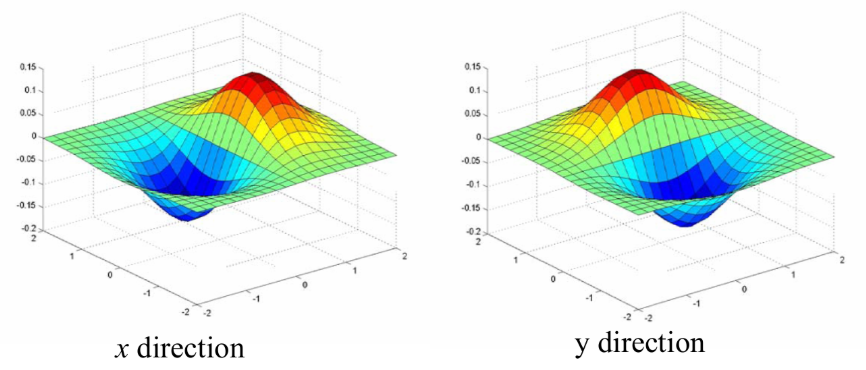
以 Gaussian filter 的 derivative (image-20250912115852371)为例:

image-20250912115717182

[^ 3]: Source: N.Snavely

higher-order derivative filters, 以及 Laplacian filter

首先, 我们来看一个方向上的二阶导的差分近似:

导两次, 那么 numerically 就是 apply 两次 derivative filter: $[1,−1]∗[1,−1]=[1,−2,1] [1,-1] *[1,-1]=[1,-2,1] 和数值二阶导的经典近似agree: 和数值二阶导的经典近似 agree: ∂2f∂x2(x)≈f(x−1)−2f(x)+f(x+1) \frac{\partial^2 f}{\partial x^2}(x) \approx f(x-1)-2 f(x)+f(x+1) $

recall Laplacian 算子: $∇2I=∂2I∂x2+∂2I∂y2 \nabla^2 I=\frac{\partial^2 I}{\partial x^2}+\frac{\partial^2 I}{\partial y^2} 我们要做出它的filter(numerical近似算子),首先用一维二阶差分近似 我们要做出它的 filter (numerical 近似算子), 首先用一维二阶差分近似 ∂2I∂x2≈I∗[1,−2,1],∂2I∂y2≈I∗[1,−2,1]T \frac{\partial^2 I}{\partial x^2} \approx I *[1,-2,1], \quad \frac{\partial^2 I}{\partial y^2} \approx I *[1,-2,1]^T $

所以二维 Laplacian 算子的差分近似即:

∇2I≈I∗[0101−41010]\nabla^2 I \approx I *\left[\begin{array}{ccc} 0 & 1 & 0 \\ 1 & -4 & 1 \\ 0 & 1 & 0 \end{array}\right]

所以 Laplacian filter 即: $[0101−41010] \left[\begin{array}{ccc} 0 & 1 & 0 \\ 1 & -4 & 1 \\ 0 & 1 & 0 \end{array}\right] $

Laplacian filter 的效果: 度量“局部强度变化的变化率”, 也是用来检测 edges 和 blobs. 不过, 从算式中就可以看出: 它不受到方向的 bias (不过对于 noise 很敏感.)
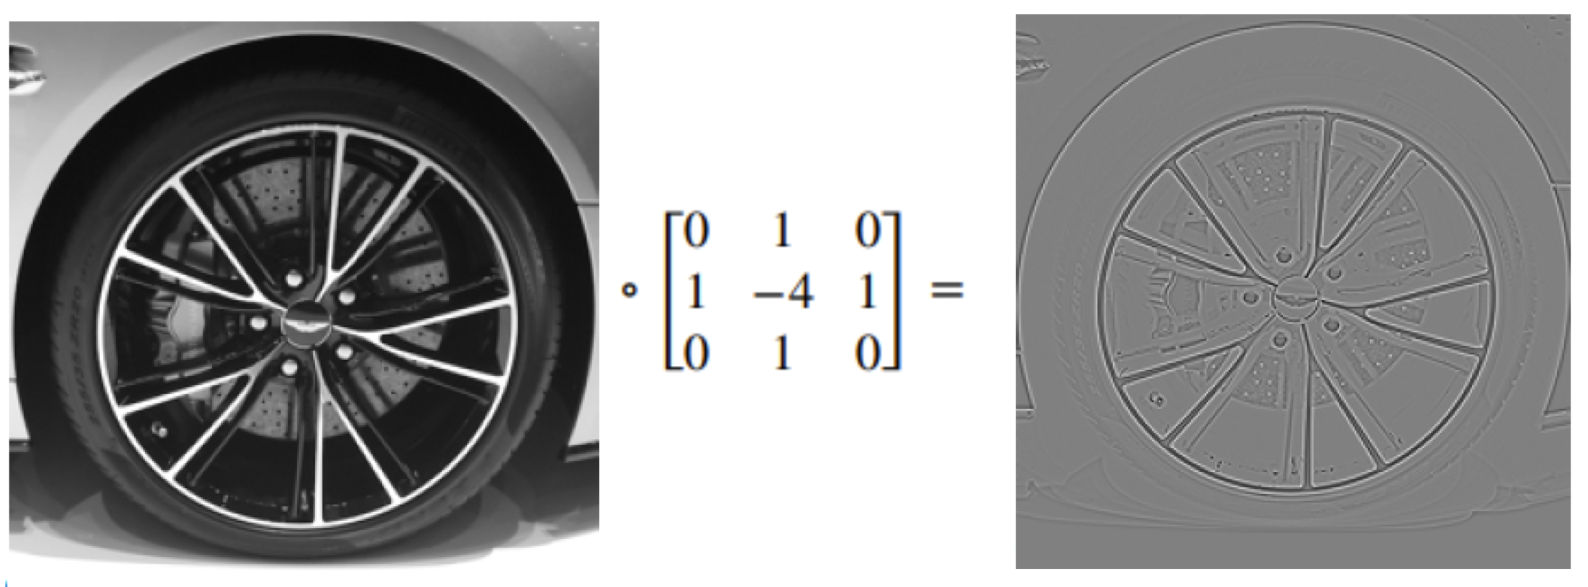
image-20250912121657873

[^4]: Source: Torralba, Freeman, Isola

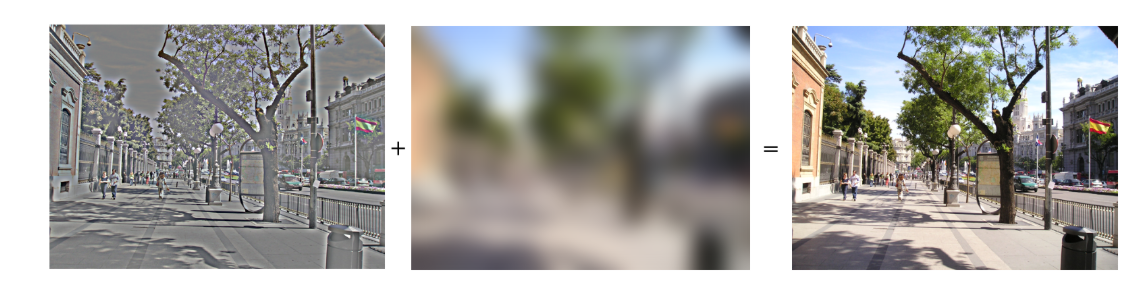
decomposing 一个 image, by Gaussian and Laplacian filtering
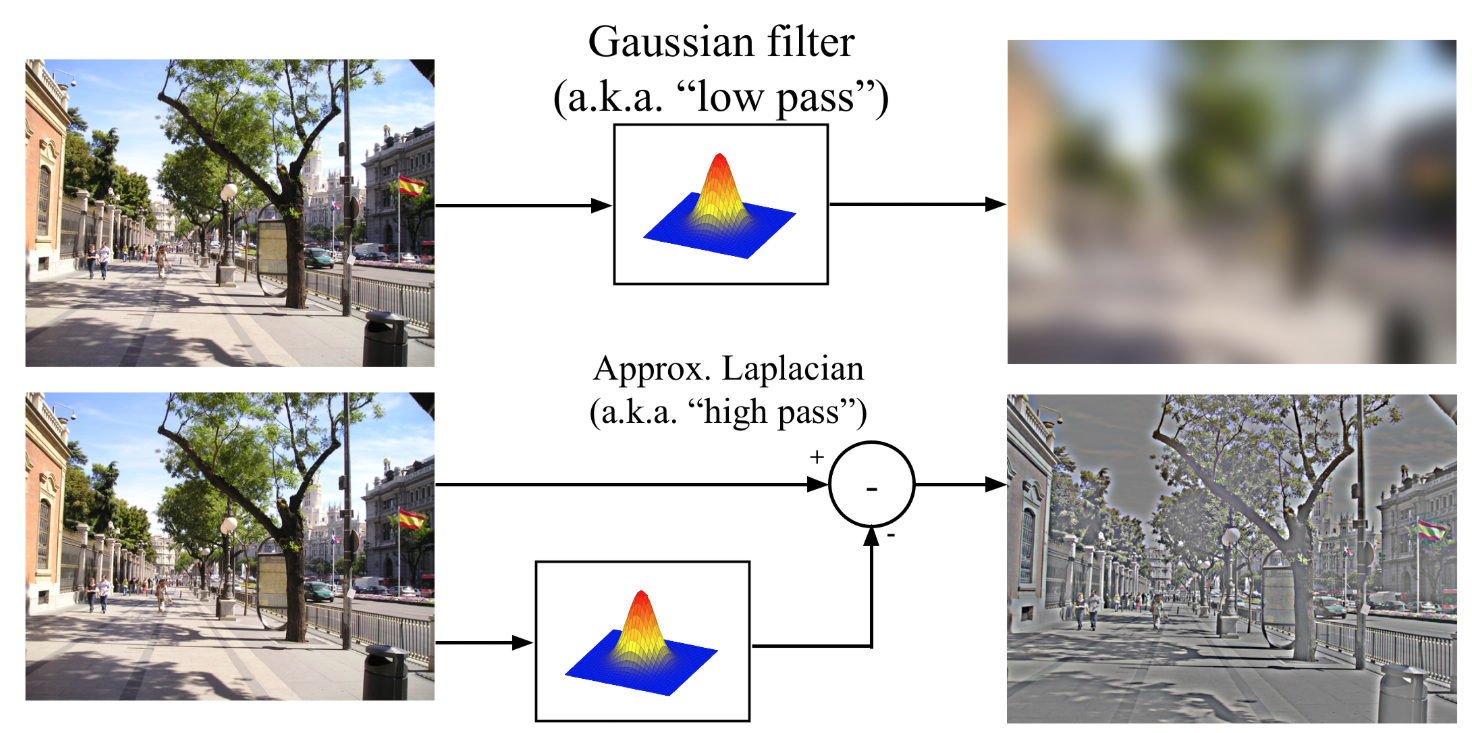
image-20250912121910525

image-20250912121935532