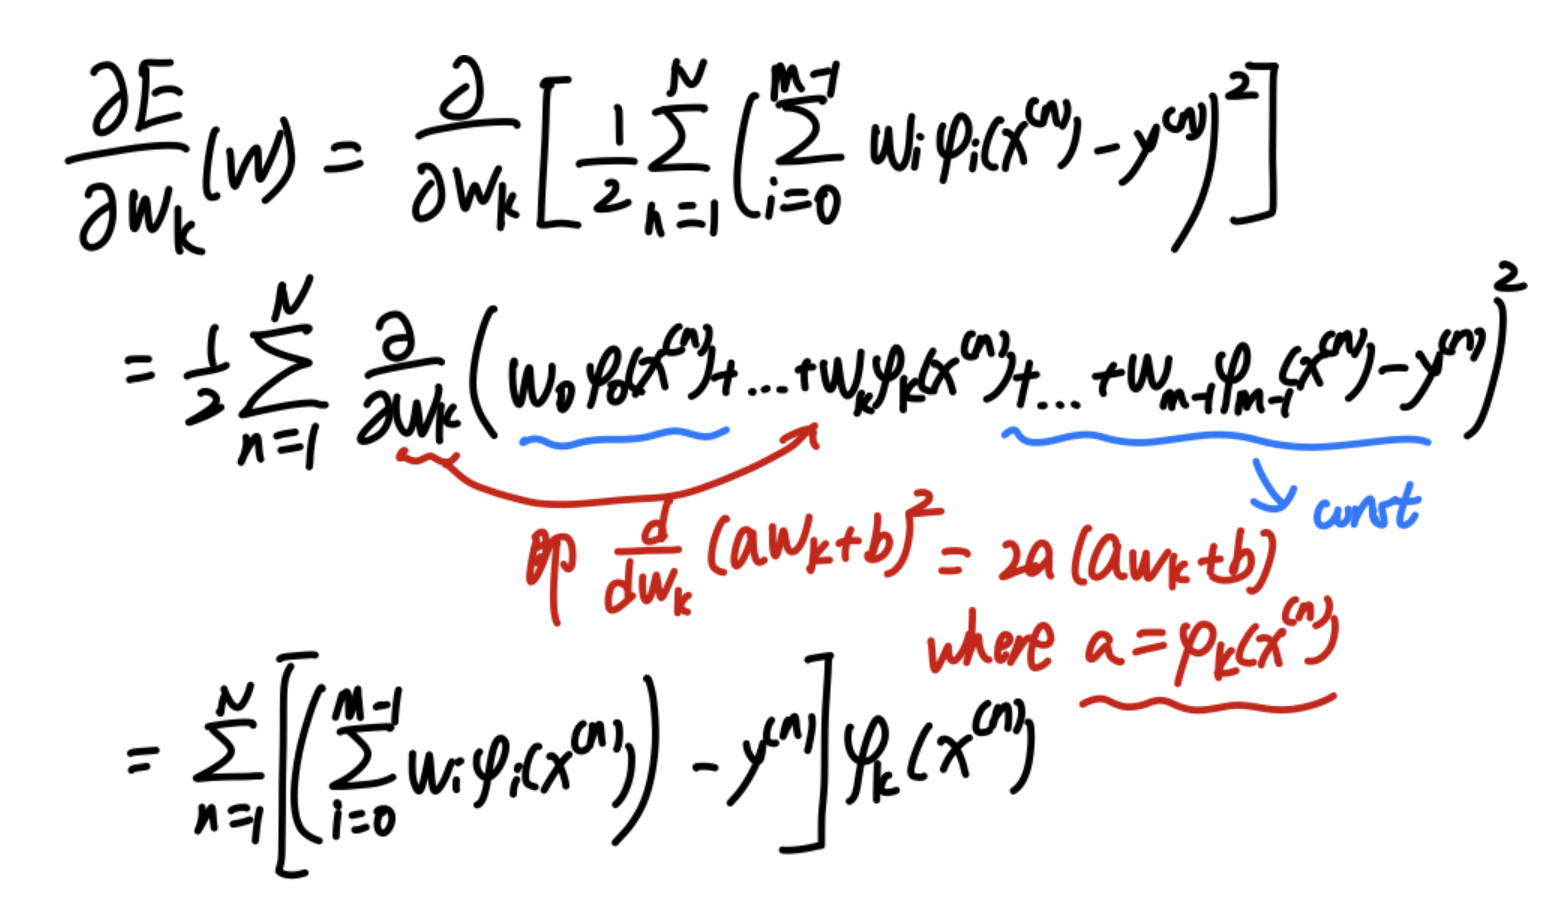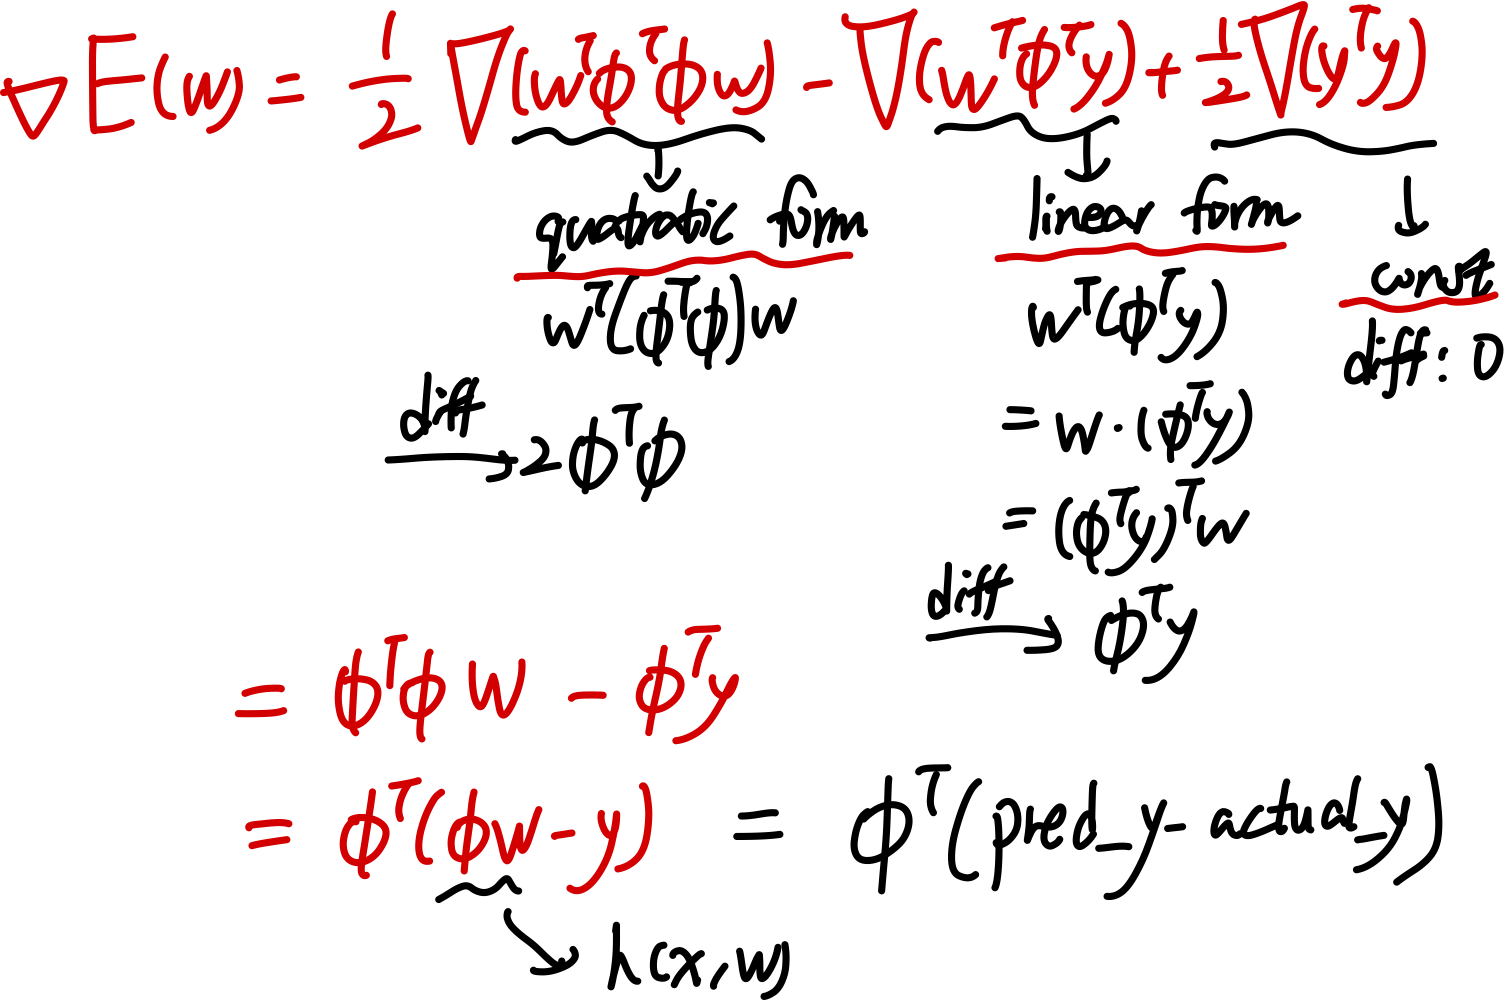cs / machine-learning

Linear Regression basics

Modeling

我们使用以下 notation:
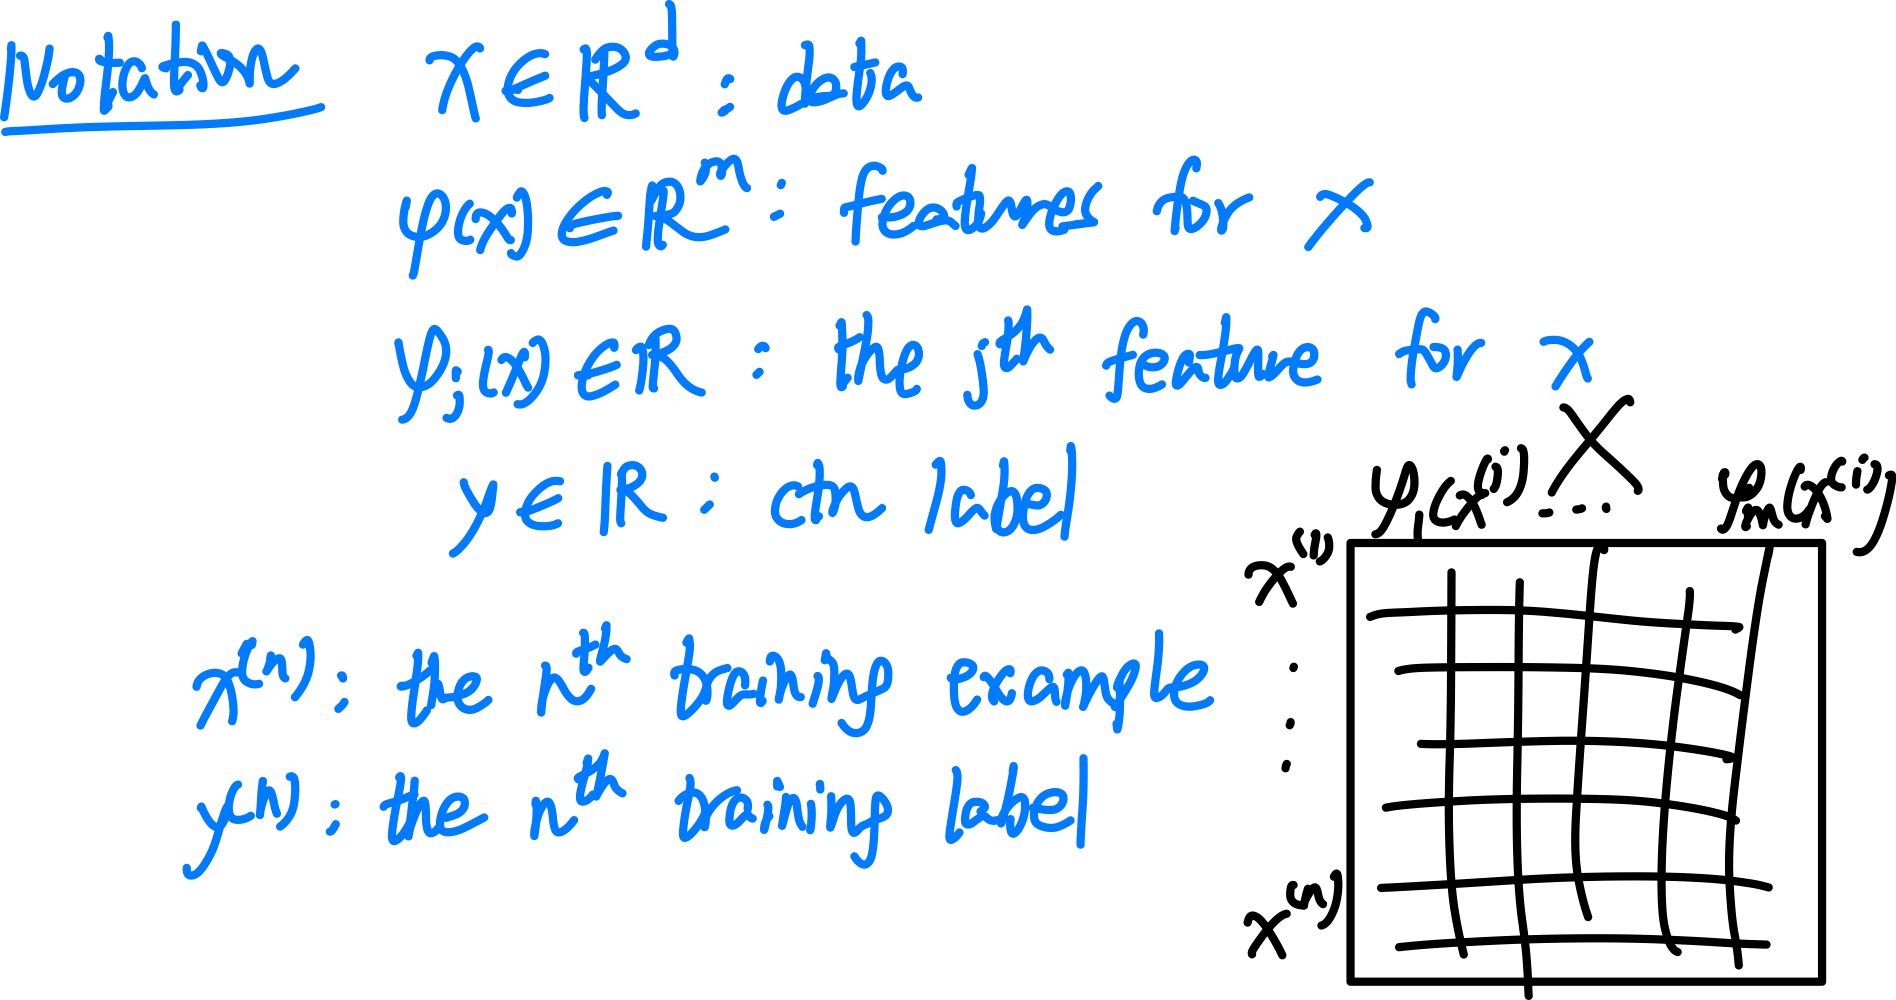
lec1-notation

(generalized) linear regression 的定义: 给定 NN 个 data points {(x(n),y(n))}n=1,⋯ ,N\{(x^{(n)},y^{(n)}) \}_{n=1,\cdots, N} where each x(n)∈Rd,y(n)∈Rx^{(n)}\in\mathbb{R}^d,y^{(n)} \in\mathbb{R}, 以及预先设定好的 MM 个 basis functions {ϕi(x)}i=1,⋯ ,M\{ \phi_i(x)\}_{i=1,\cdots, M} 用以表示 MM 个 features;

我们通过建立一个 h(x,w):Rd×RM→R=∑i=0M−1wiϕi(x)h(x,w): \mathbb{R}^d \times \mathbb{R}^M \rightarrow \mathbb{R} = \sum_{i=0}^{M-1} w_i \phi_i(x), 使其关于 ww 线性, 以找到一组参数 w∈RMw \in \mathbb{R}^M, 使得 h(x(n),w)h(x^{(n)},w) 能够近似 y(n)y^{(n)} for each nn, with respect to the loss function we define to measure the distance between two vectors.
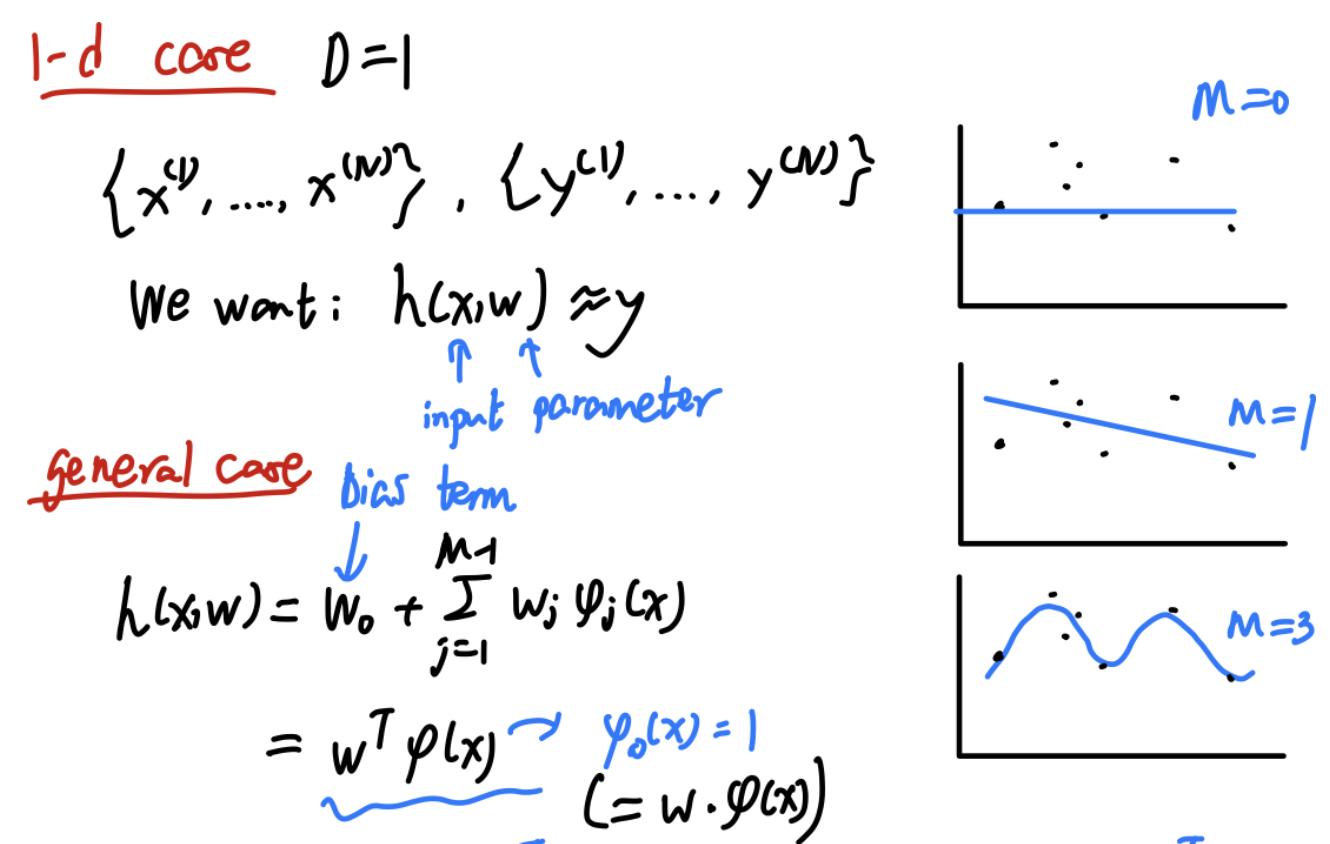
Screenshot 2025-04-08 at 12.10.51

其中 $w=(w0,…,wm−1)⊤,φ(x)=(1,φ1(x),…,φm−1(x))⊤ \begin{aligned} & w=\left(w_0, \ldots, w_{m-1}\right)^{\top}, \varphi(x)=\left(1, \varphi_1(x), \ldots, \varphi_{m-1}(x)\right)^{\top}\end{aligned} $

w=[w0⋮wm−1],φ(x)=[1⋮φm−1(x)]w=\left[\begin{array}{c}w_0 \\ \vdots \\ w_{m-1}\end{array}\right], \varphi(x)=\left[\begin{array}{c}1 \\ \vdots \\ \varphi_{m-1}(x)\end{array}\right]

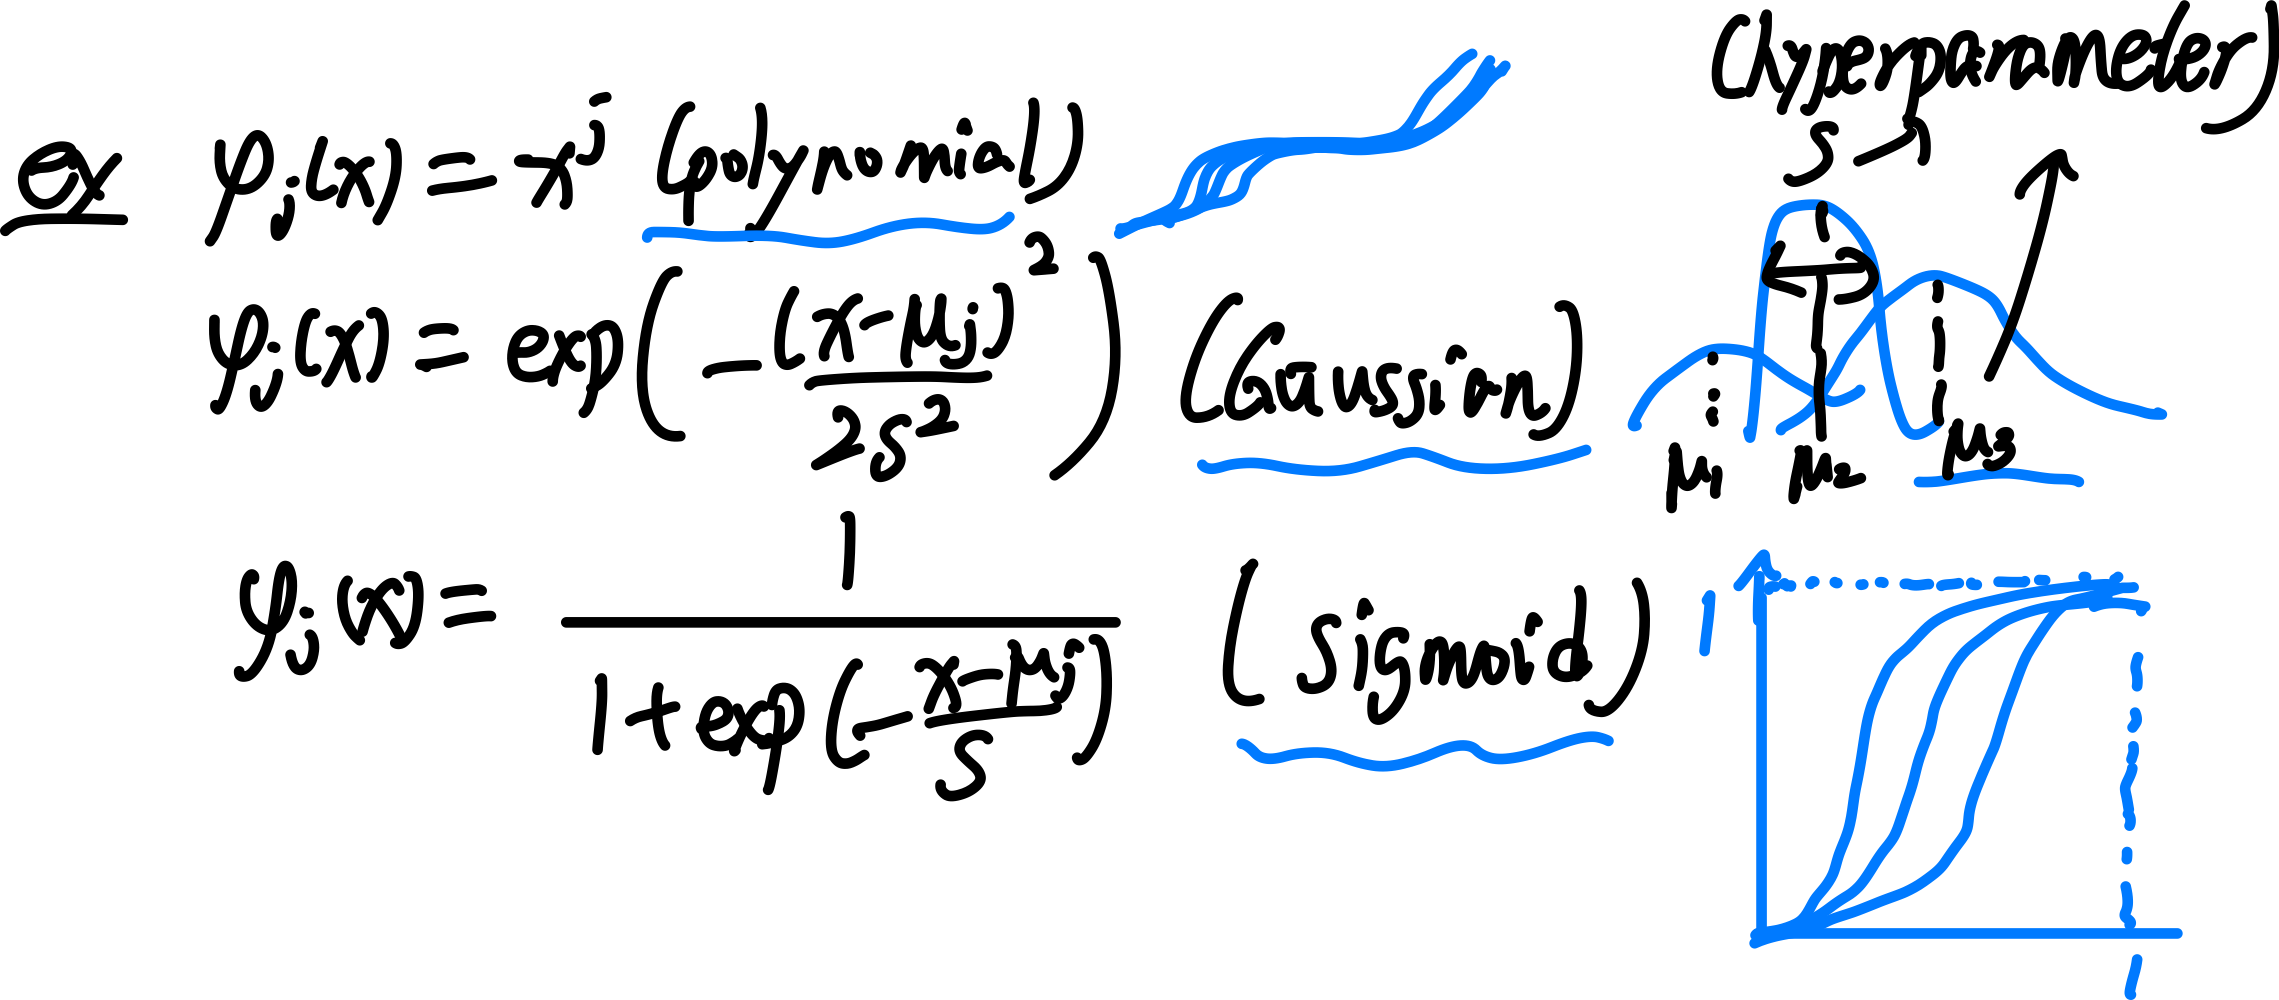
Remark: 注意 linear regression 指的是 yy 和参数 ww 之间是 linear 的, 而不是说 yy 和 input xx 之间是 linear 的. 我们可以选择 nonlinear 的 basis funtions 来 encode xx 来表示 features 的特性, 比如我们可以选择:

lec1-basis

loss function: sum of squared error

这个 loss function 衡量两个 vectors 之间的距离, 目的是衡量 y∈RNy \in \mathbb{R}^N 和 h(x,w)∈RNh(x,w) \in \mathbb{R}^N 这两个 vectors 的差距. 实际上就是它们 difference 的 L2L_2-norm 的平方.

sum of squares error: $E(w)=12∑n=1N∥h(x(n),w)−y(n)∥22=12∑n=1N(∑i=0M−1wiφi(x(n))−y(n))2 \begin{aligned} E(w) & =\frac{1}{2} \sum_{n=1}^N\left\|h\left(x^{(n)}, w\right)-y^{(n)}\right\|_2^2 \\ & = {\frac{1}{2} \sum_{n=1}^N\left(\sum_{i=0}^{M-1} w_i \varphi_i\left(x^{(n)}\right)-y^{(n)}\right)^2} \end{aligned} $

gradient of sum of squared error

∇E(w)=[∂E∂w0(w)⋮∂E∂wm(w)]\nabla E(w)=\left[\begin{array}{c} \frac{\partial E}{\partial w_0}(w) \\ \vdots \\ \frac{\partial E}{\partial w_m}(w) \end{array}\right]

我们下面首先通过求 ∇E(w)\nabla E(w) 的每个 entry ∂E∂wk(w)\frac{\partial E}{\partial w_k}(w) 来写出这个 gradient.

Screenshot 2025-04-08 at 12.18.20

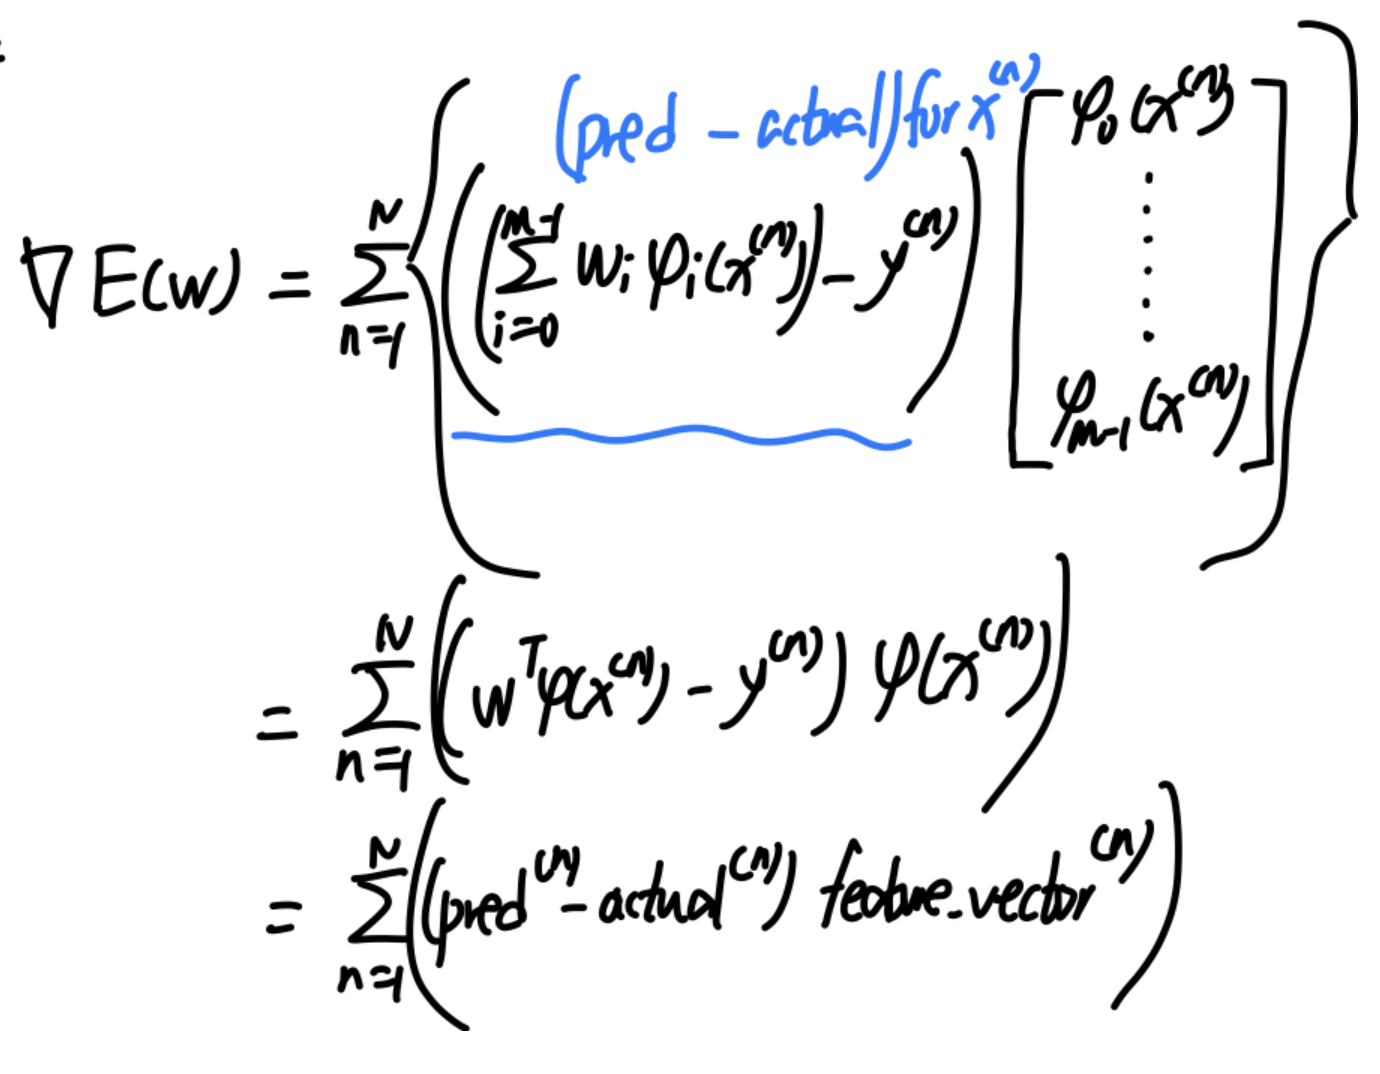
因而 vectorize:

Screenshot 2025-04-08 at 12.18.46

batch v.s. stochastic GD

我们通过迭代降低 gradient 来降低 loss function 的值, 从而优化 weight vector.
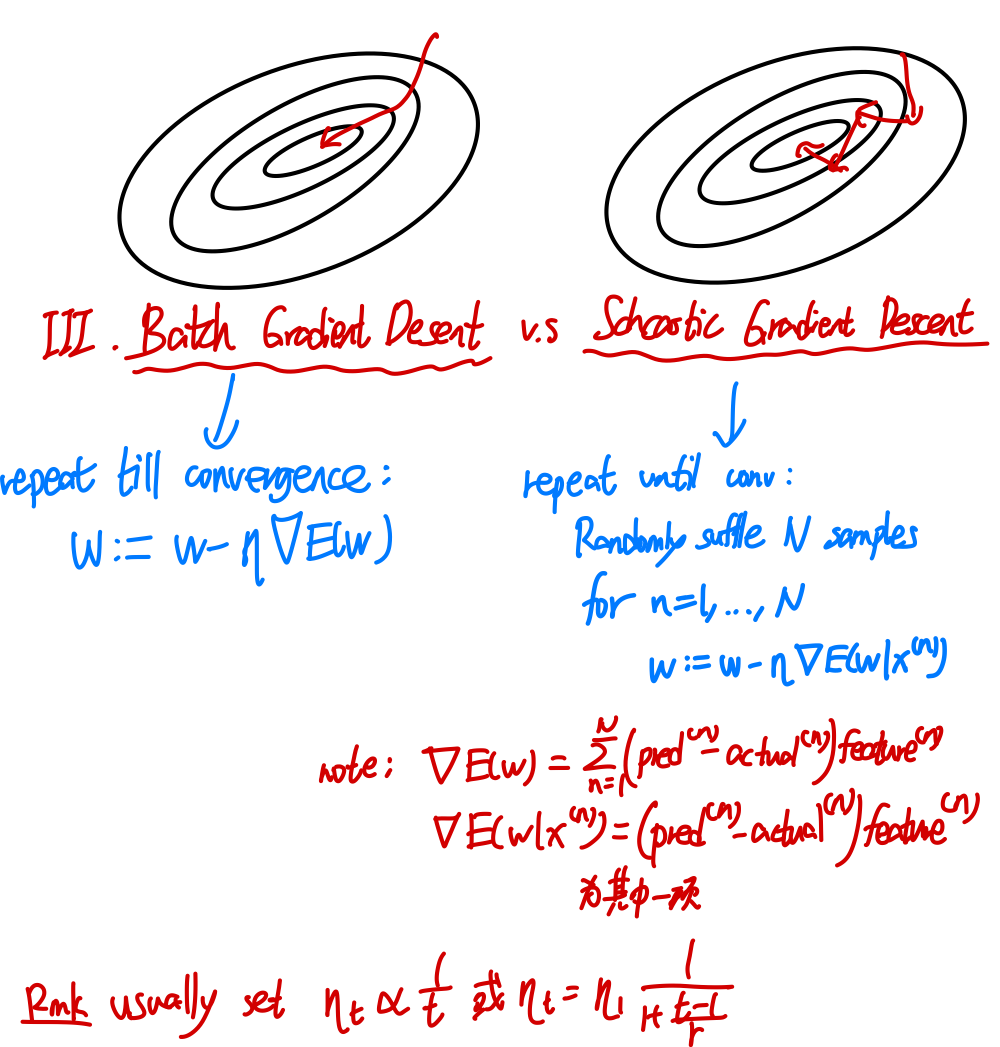
lec1-descent

(More practically, 我们可以采用 minibatch SGD: 即在 batch GD 和 SGD 之间, 每次选择一小部分 samples, 称为一个 minibatch, 在这个 minibatch 上进行 GD.)

vectorization

我们可以把每个 x(n)x^{(n)} 的 features 写成一个 row vector, 并 stack up NN 个 row vectors, 成为一个 N×MN\times M 的 matrix Φ\Phi. 从而: $h(x,w)=Φw h(x,w) = \Phi w vectorization的好处是:1.便于手算;2.computer可以进行并行计算.\pic[0.6]assets/lec2−vect.png计算得linearregression的lossfunction为: vectorization 的好处是: 1. 便于手算; 2. computer 可以进行并行计算. \pic[0.6]{assets/lec2-vect.png} 计算得 linear regression 的 loss function 为: E(w)=12wTΦTΦw−wTΦTy+12yTy E(w) = \frac{1}{2}w^T \Phi^T \Phi w - w^T \Phi^T y + \frac{1}{2}y^T y $

vector form gradient 以及 closed-form sol

如果 $∇E(w)=y \nabla E(w) = y 有一个closedformsolution,那么这个solution一定是一个localmin/max,从而possibly成为一个globalmin.(并且weknow,∗∗如果 有一个 closed form solution, 那么这个 solution 一定是一个 local min/max, 从而 possibly 成为一个 global min. (并且 we know, **如果 E$ 是个 convex 的函数, 那么一定是 global min!**)

为了计算 closed form solution, 我们首先要给出 ∇E(w)\nabla E(w) 的 matrix form 表达式. \ 这里首先引入 linear form 和 quadratic form 的 gradient:
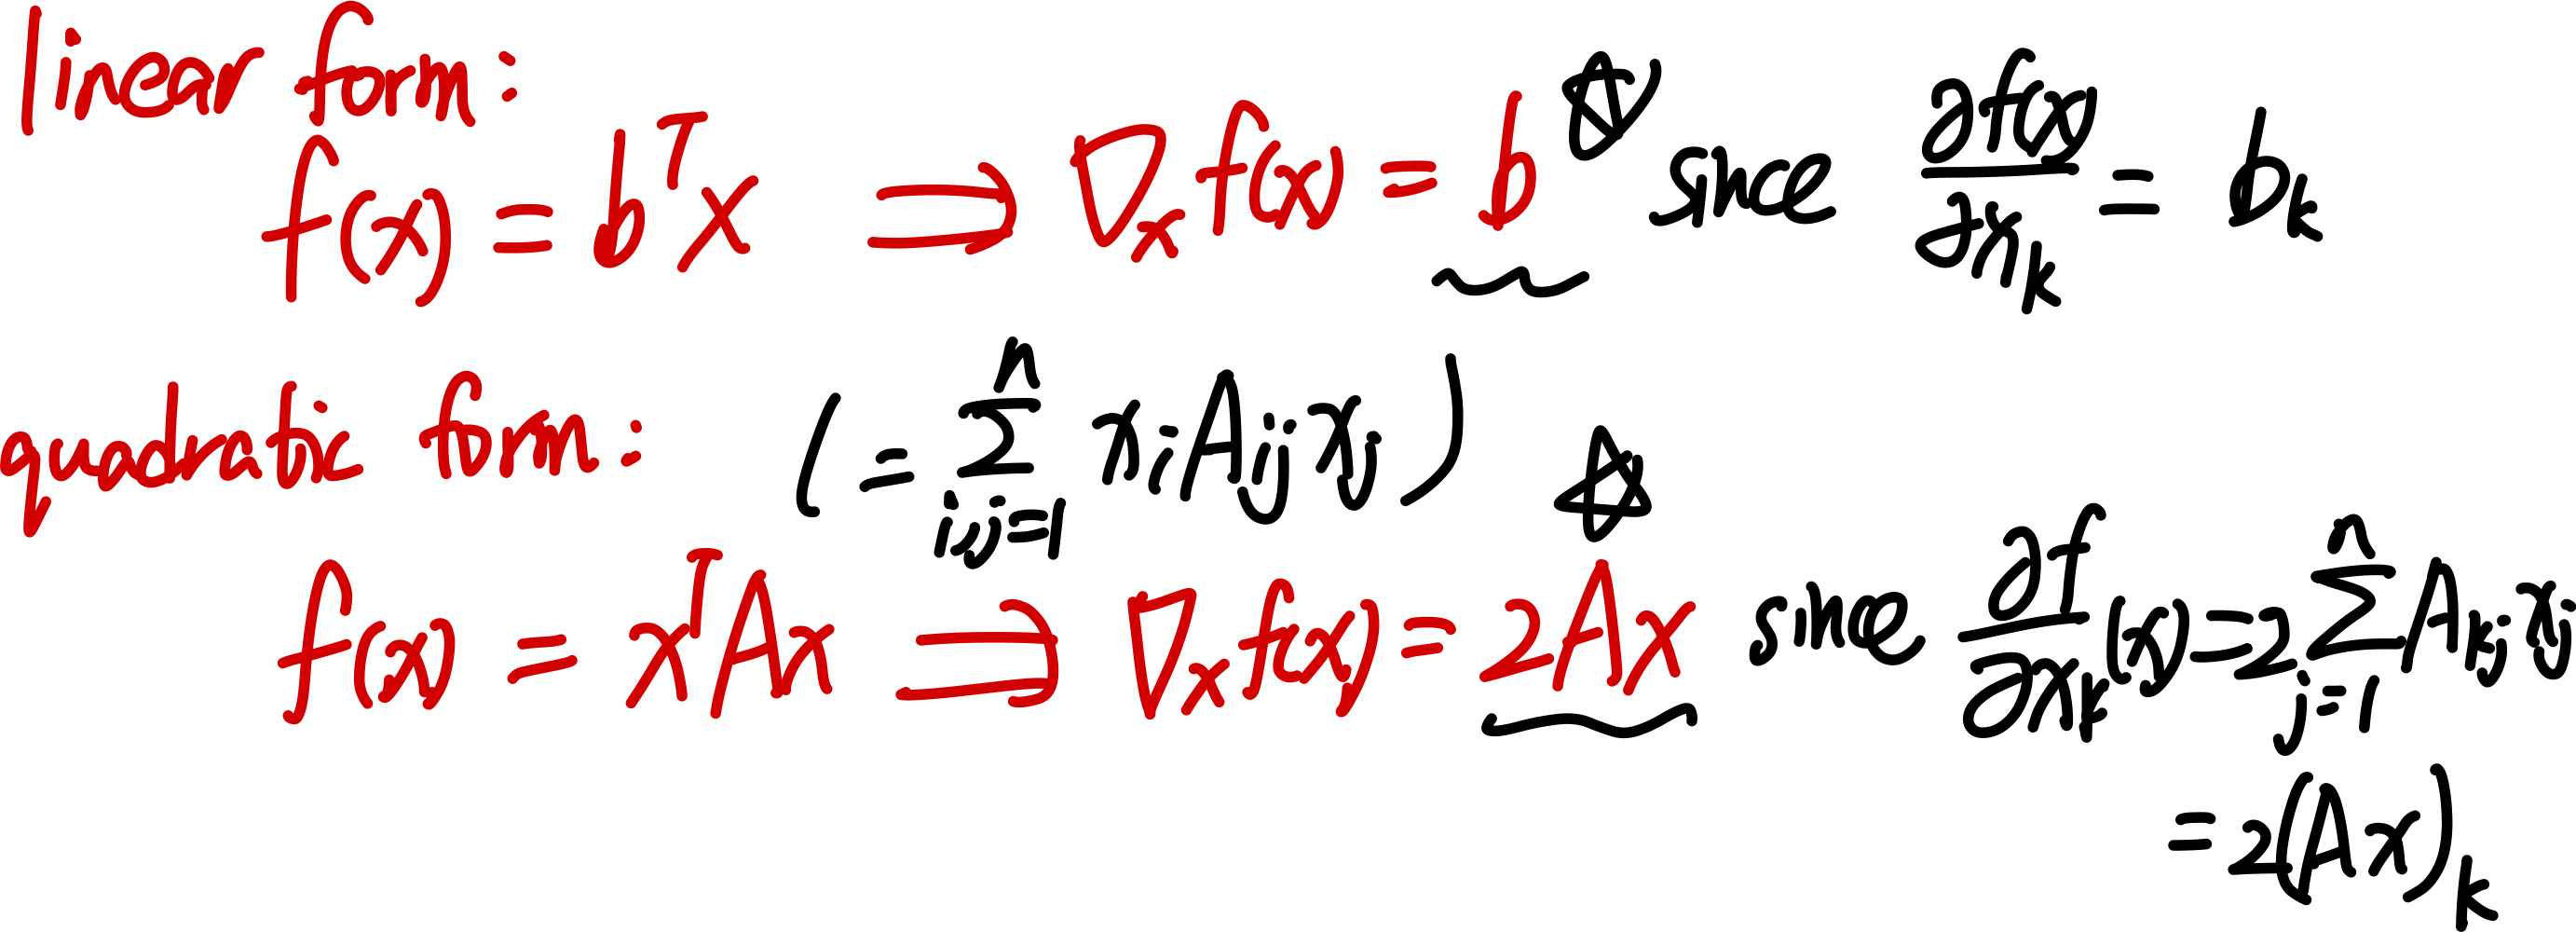
lec2-diff

我们发现: E(w)E(w) 就是一个 ww 的 quadratic form, 一个 ww 的 linear form 和一个 const 的组合. 从而可以求出:

lec2-grad

从而我们得到 closed form solution (if exists):
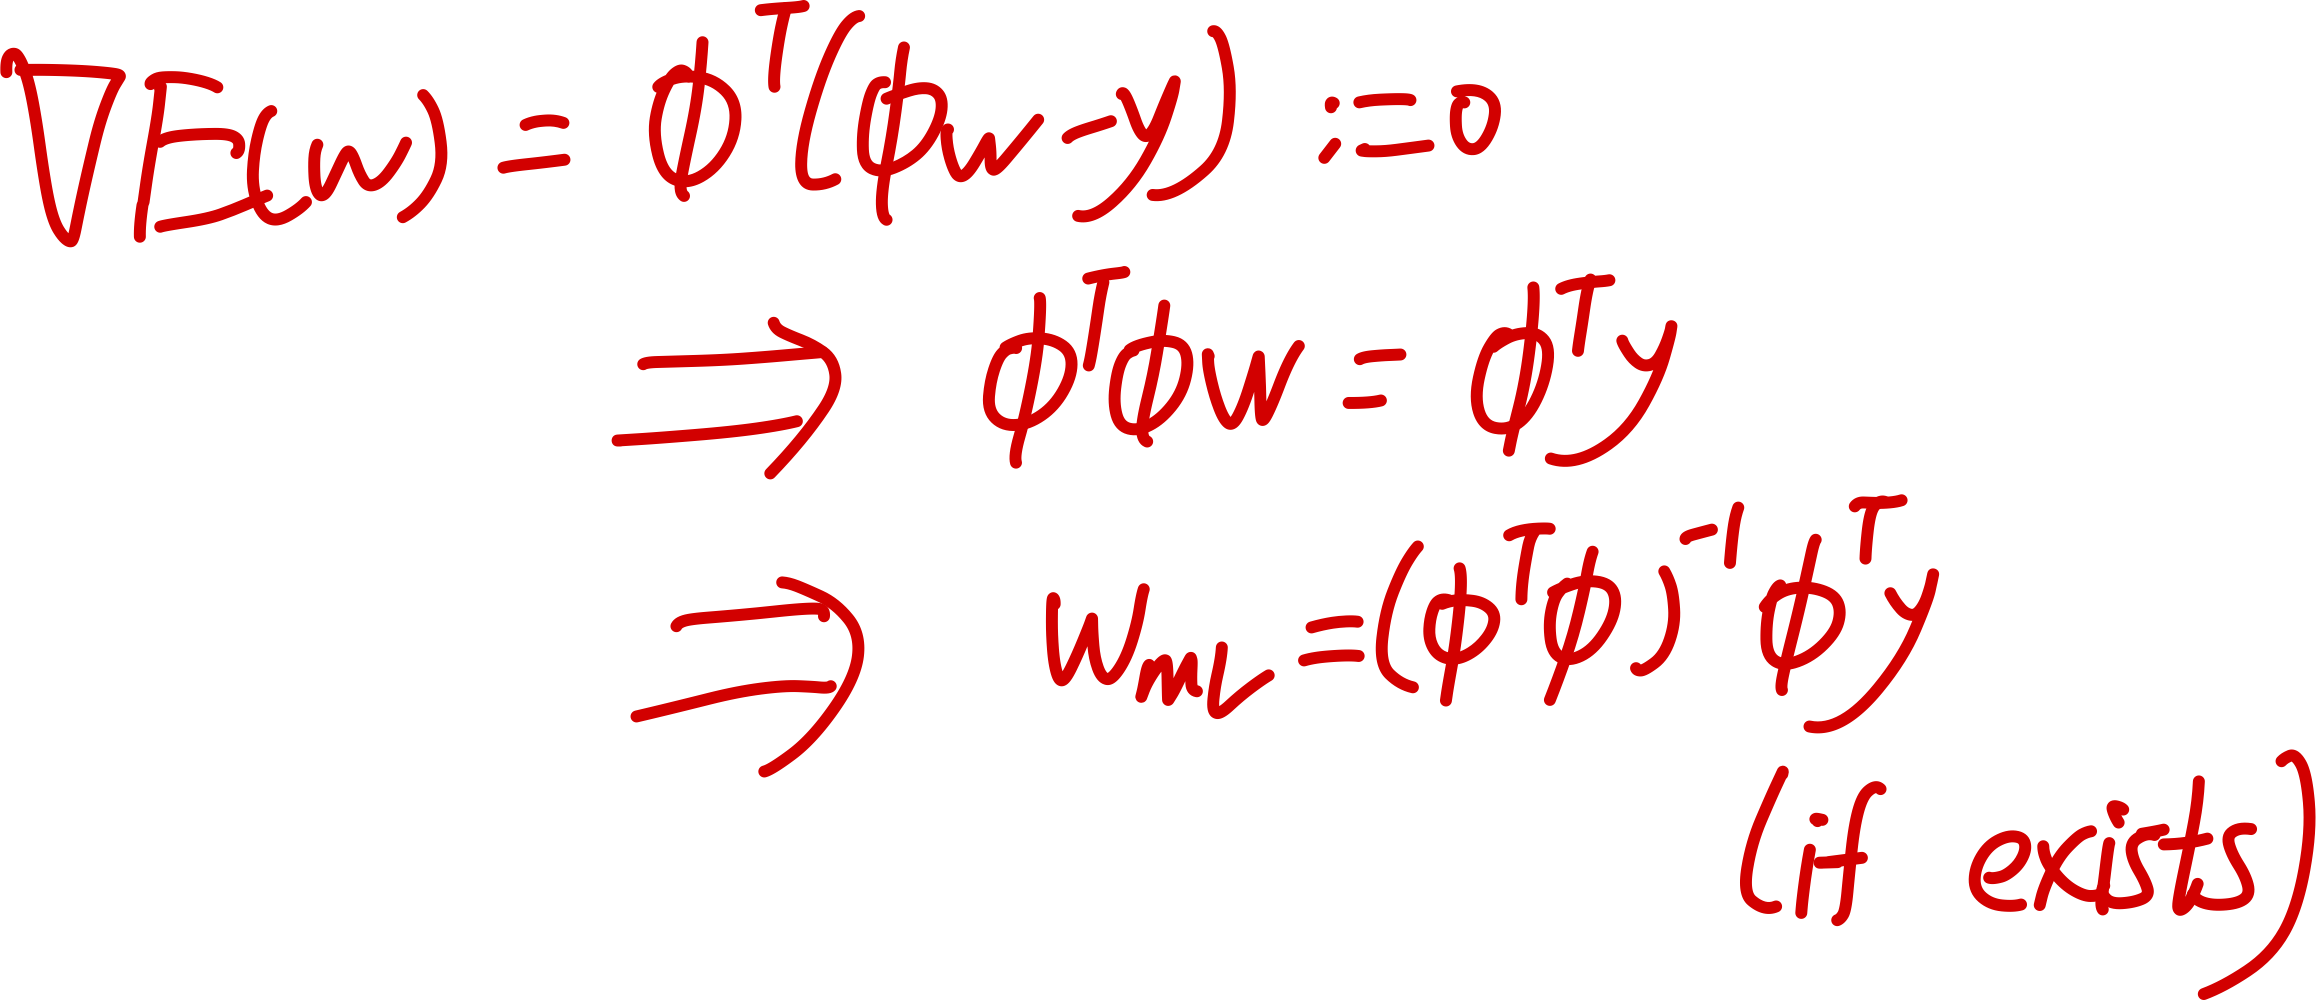
lec2-closed

因而 closed form exists iff ΦTΦ\Phi^T\Phi 可逆, iff Φ\Phi 可逆. 并且 recalll in linear algebra: rank(ΦTΦ)=rank(Φ)rank(\Phi^T\Phi) = rank(\Phi). 因而, closed form exists iff M>=NM >= N 且 rank(Φ)=Nrank(\Phi) = N

overfitting

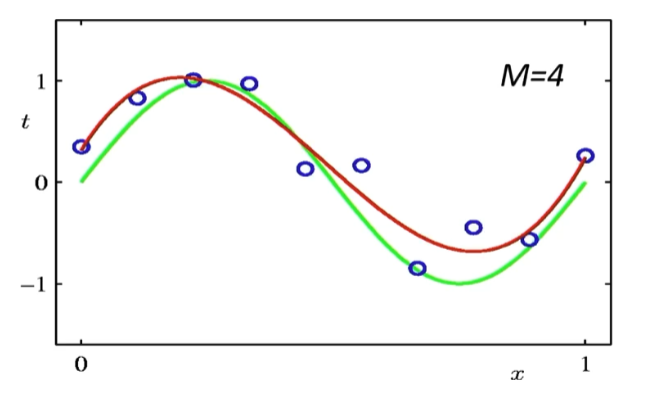
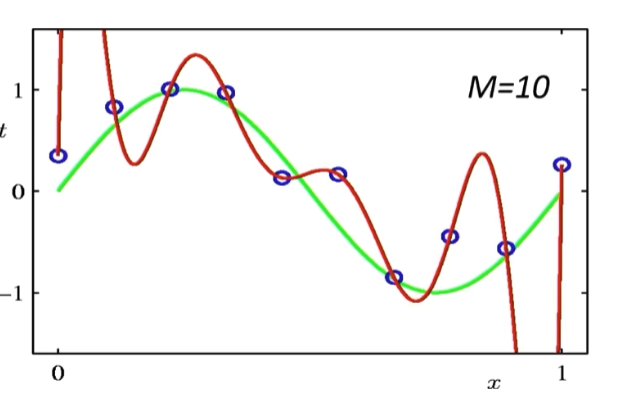
image-20250121173433845 Screenshot 2025-01-21 at 18.11.37

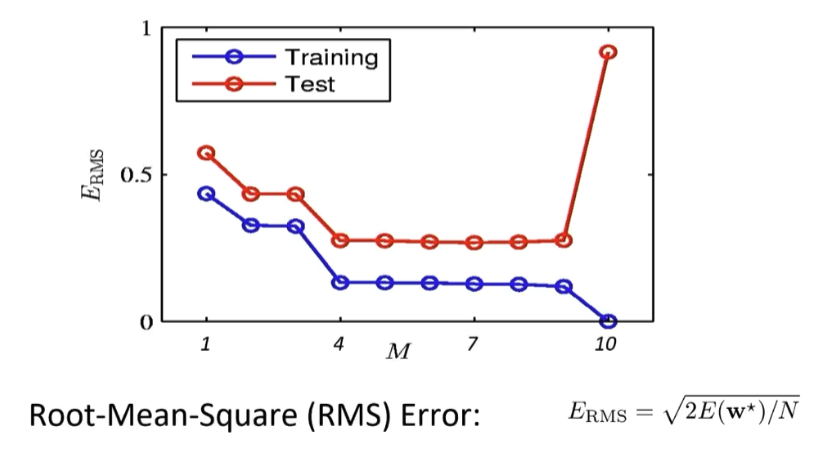
overfitting 的原因: features 数量 M 设置得太多, 导致过度保持 training sets 的点靠近曲线, 但是对于 testing set 并不对( 这里是一个简化, 实则不能单纯这样划分, 需要 cross validation)
Screenshot 2025-01-21 at 18.11.50

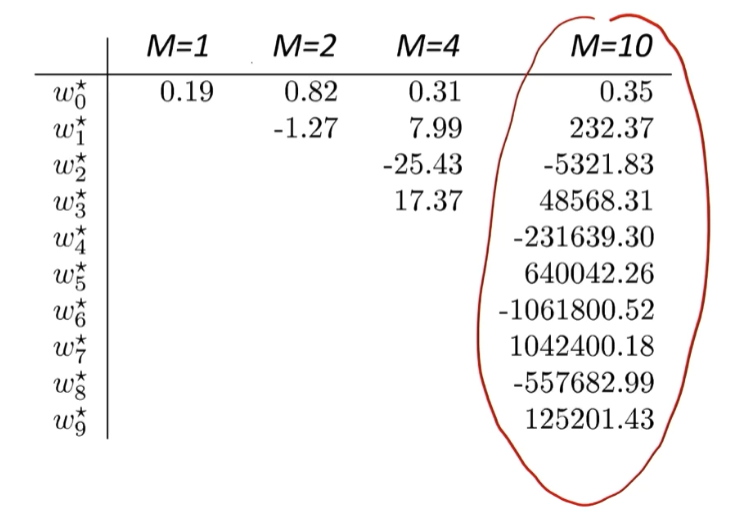
overfitting 的表现: 各项 features 的参数动荡很大.
Screenshot 2025-01-21 at 18.12.41

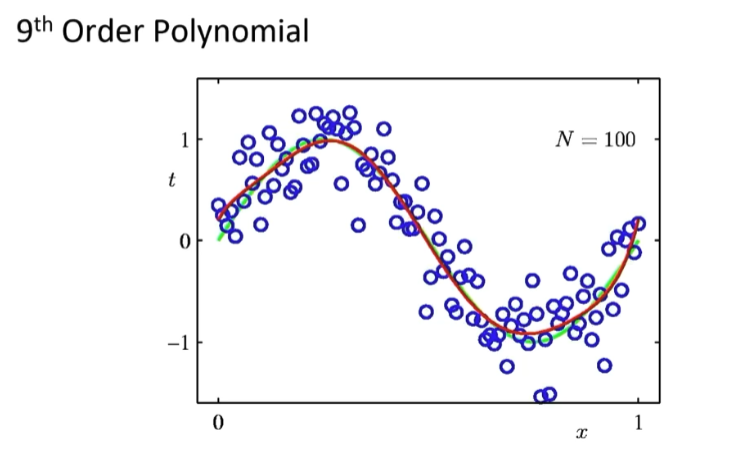
overfitting 的解决方法 1: 增加数据点

Screenshot 2025-01-21 at 18.13.03

overfitting 的解决方法 2:

regularization: solving overfit

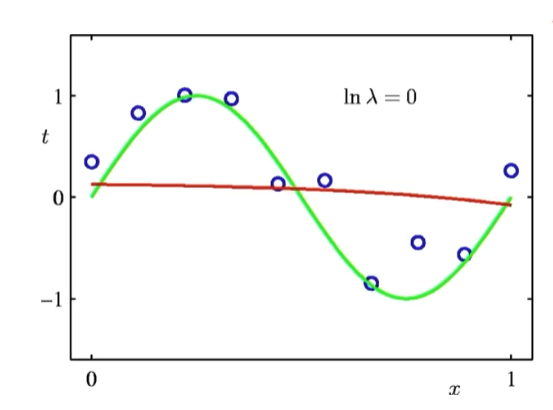
我们通过引入一个 regularization term, 也称为 penalty term 惩罚项, 以使得曲线尽量平缓, 从而减少 overfitting.

Idea: 把 ww 本身的 Magnitute 作为一个 loss function 的一部分, 让我们降低 loss 的同时自带降低 w 的各个 entries 的正负动荡程度, 从而使得拟合曲线尽量平缓, 降低曲线的 expressibility.
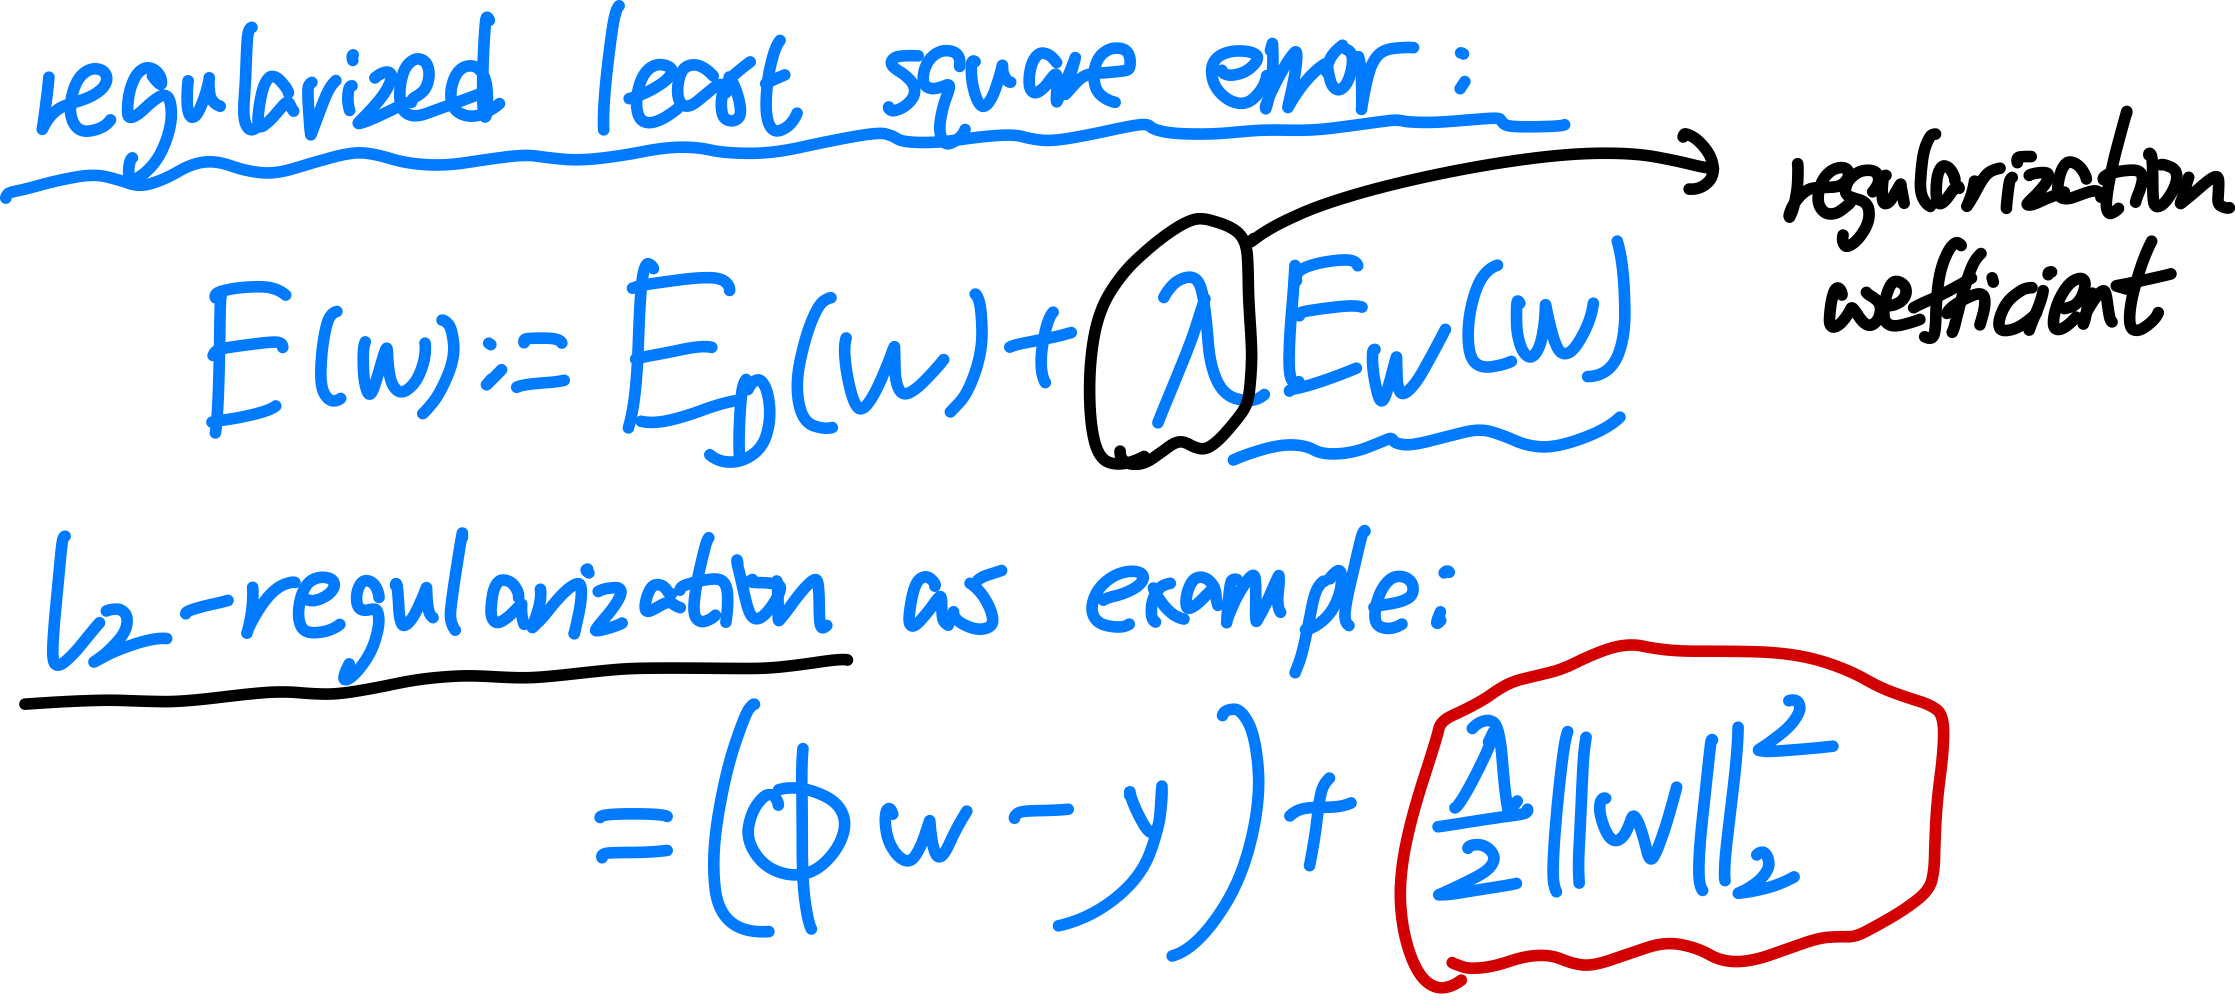
image-20250121201523836

这里的 λ\lambda 理应设置较小, 如 0.001 等.

λ\lambda 设置越大, 曲线越接近 constant. 比如 λ:=1\lambda := 1, 则会

Screenshot 2025-01-21 at 20.17.21

如果 traning error 和 testing error 都很大, 那就说明 λ\lambda 调太大了.

gradient of regularized least square
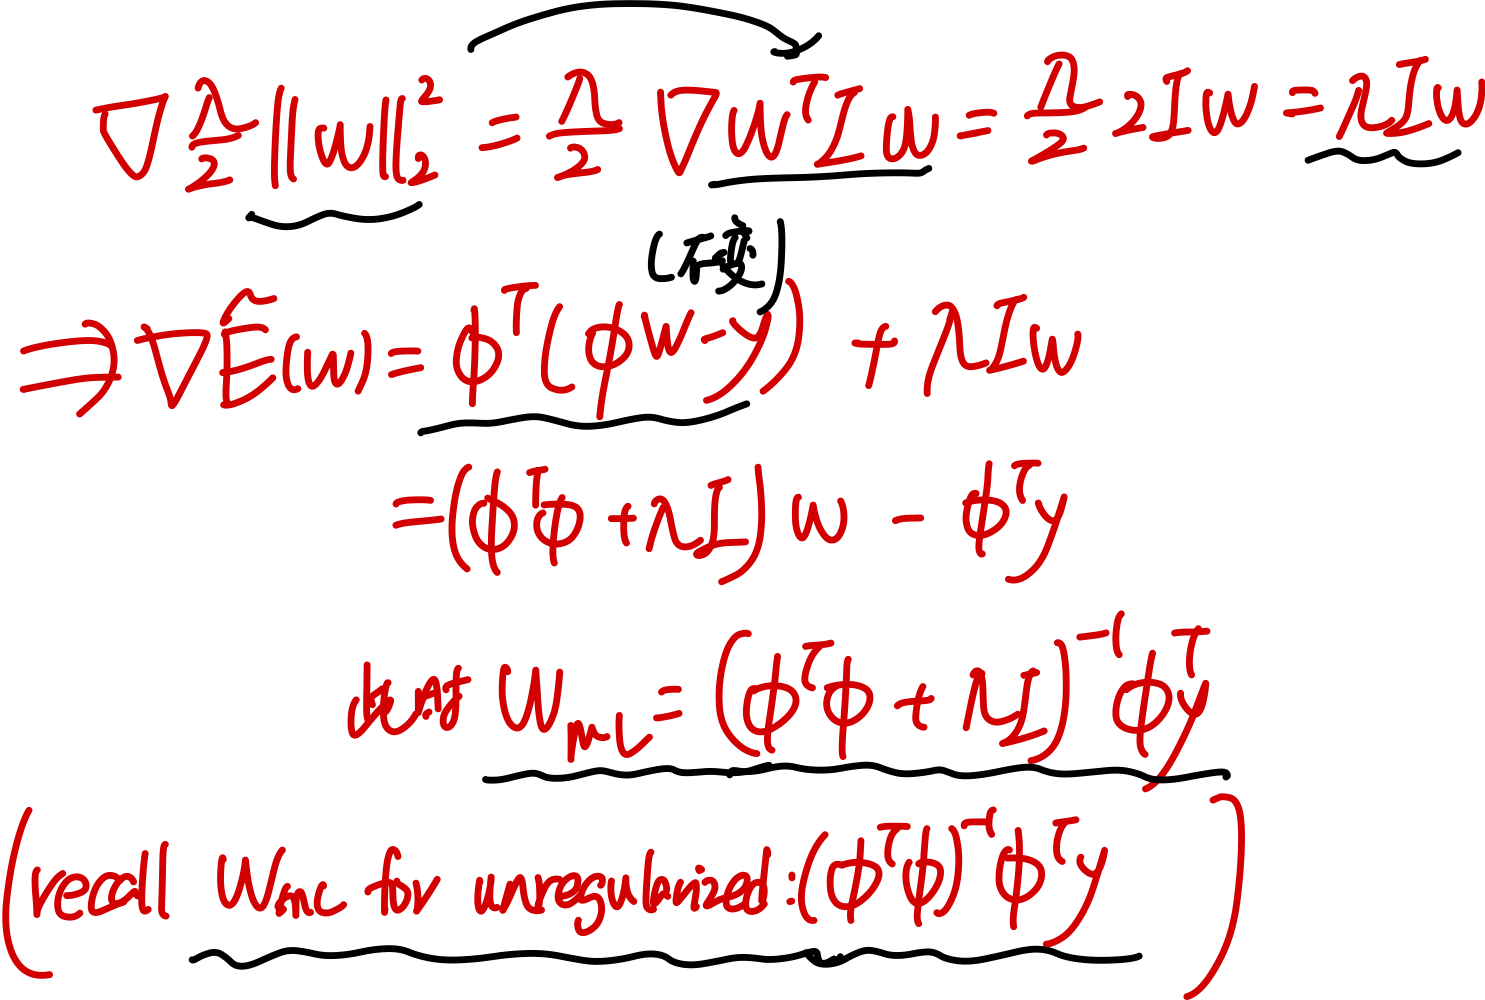
image-20250121204803377

summary: regularization controls the tradeoff bewteen fitting error 和 expressibility.

Linear Regression(lec3)

Review on Probability
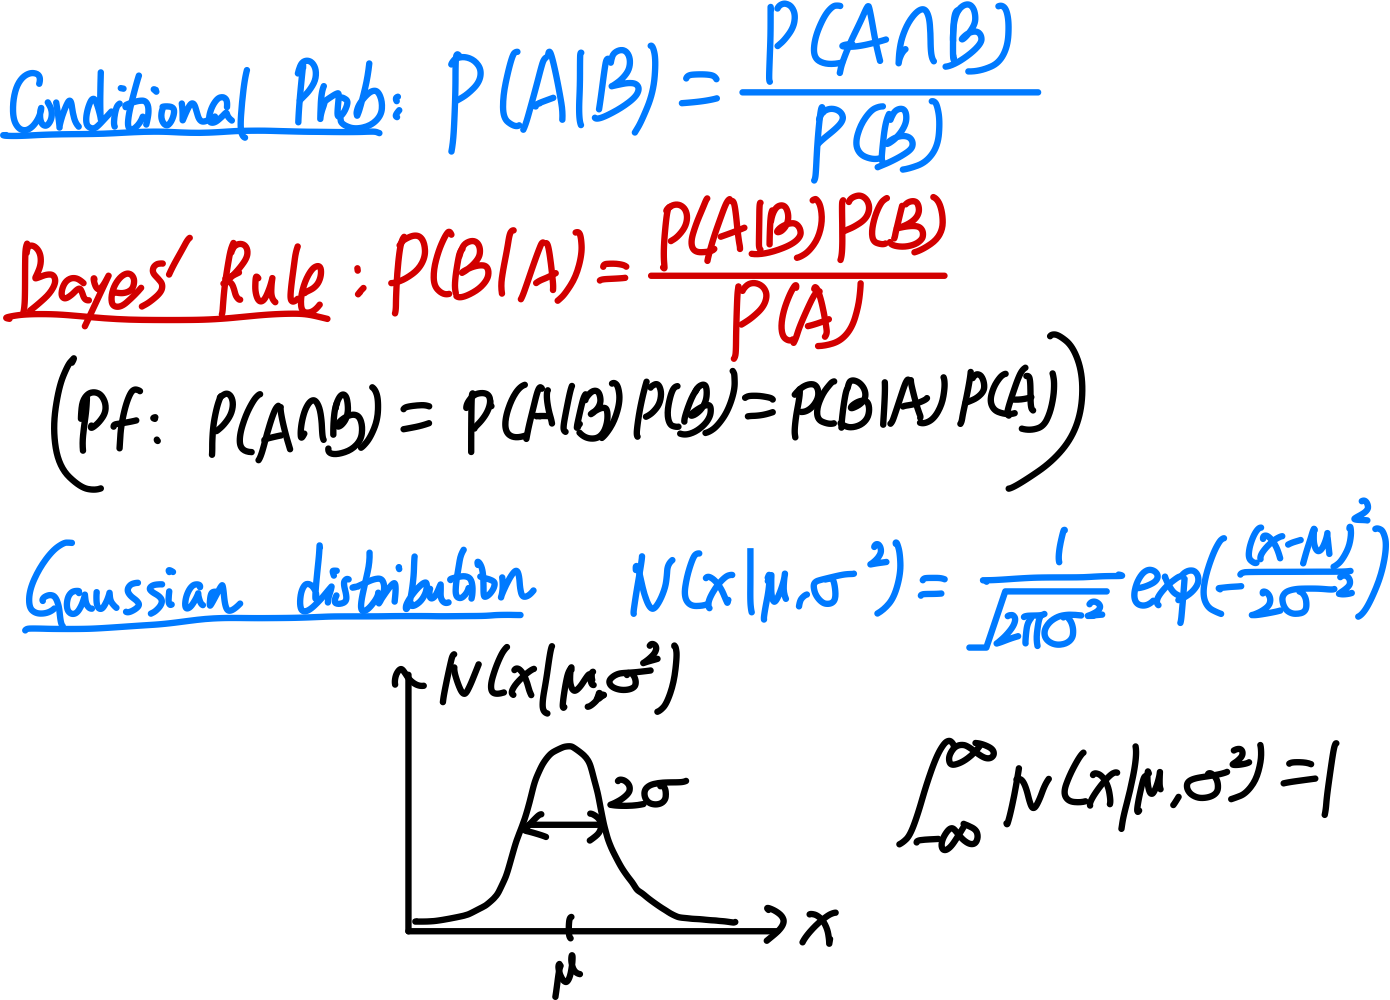
image-20250121215444693

Likelihood function

Likelihood function (似然函数) 表示在给定一组 i.i.d 的数据 samples DD 以及其以 θ\theta 为参数的分布形式下,random vector =DD 处的概率密度;其以参数 θ\theta 为变量,表达的是在固定数据 DD 的前提下,不同参数 θ\theta 对数据的适配程度

而 maximum likelihood estimator 则是使得这个 random vector =DD 处的概率密度 maximize 的参数 θ~\tilde{\theta}

由于独立同分布, random vector =D:={x1,⋯ ,xn}D:=\{x_1,\cdots,x_n\} 处的概率密度就等于所有 X=xiX=x_i 处的概率密度的 product.

取得 maximum likelihood estimator 即: 在这个参数下, 我们得到的模型, 对于我们的训练数据而言, 取得其相对的 y 的概率密度最大.
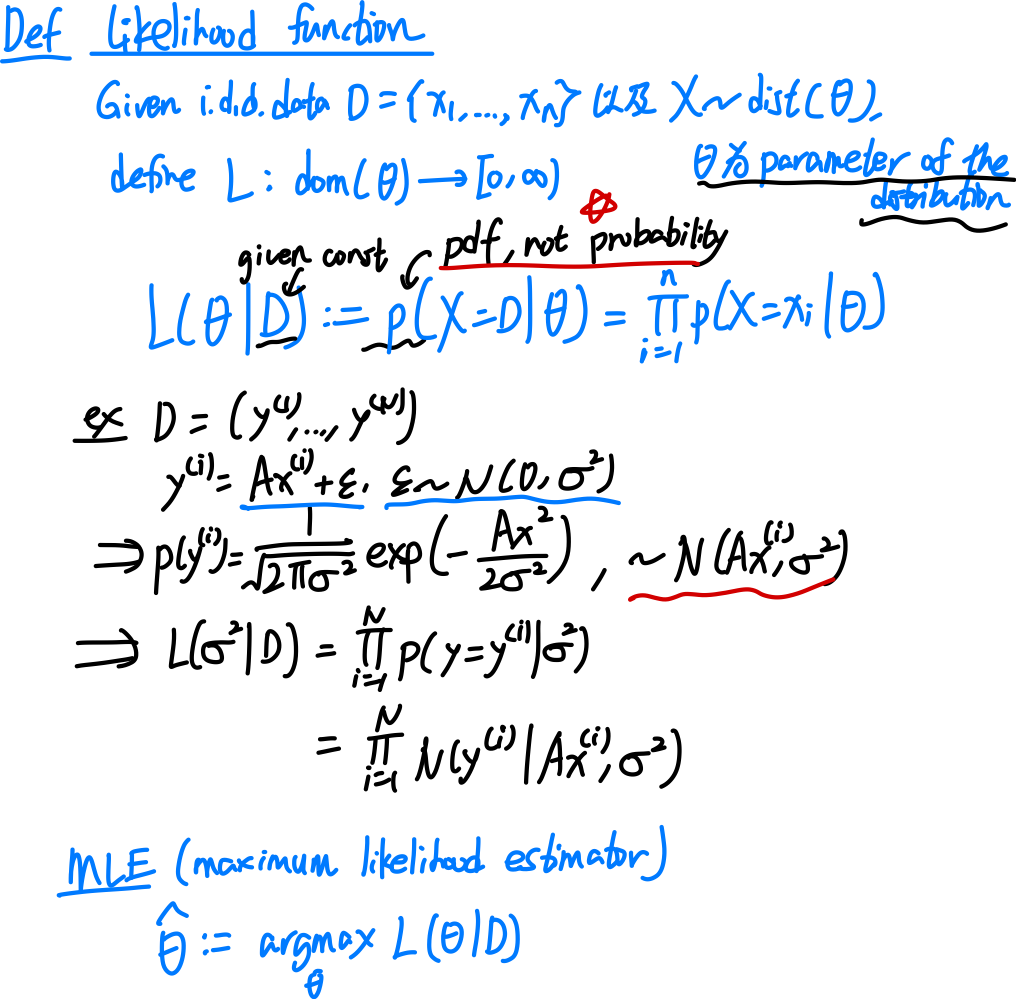
image-20250123174328307

Find MLE for linear model with stochastic noise
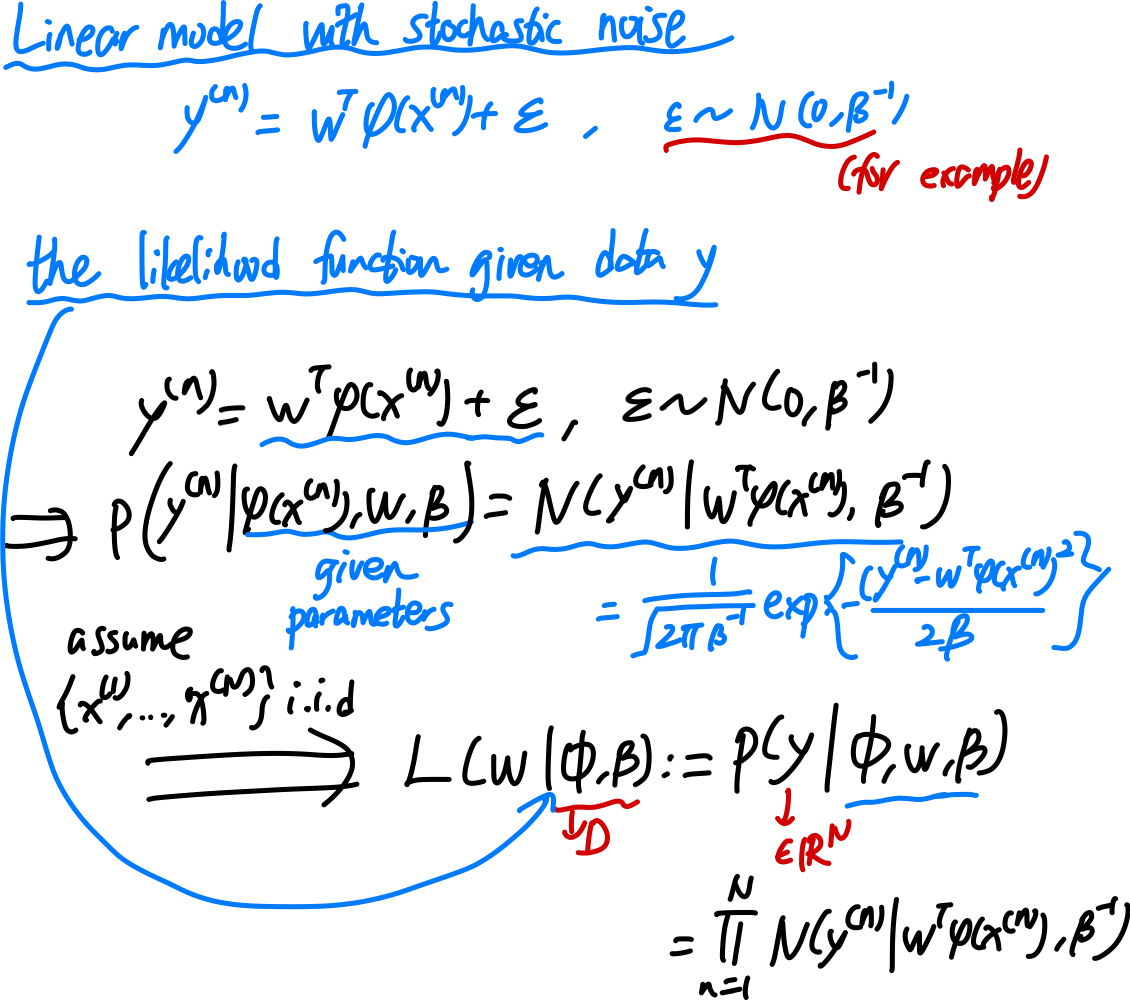
image-20250123180811150

(求解MLE 可得: linear model with stochastic noise which is normal distributed centered at 0 得到的 MLE,与标准的 linear model 得到的 MLS 最优解是等价的.

这是符合直觉的,因为一个正态分布的 noise 不影响参数的选择)
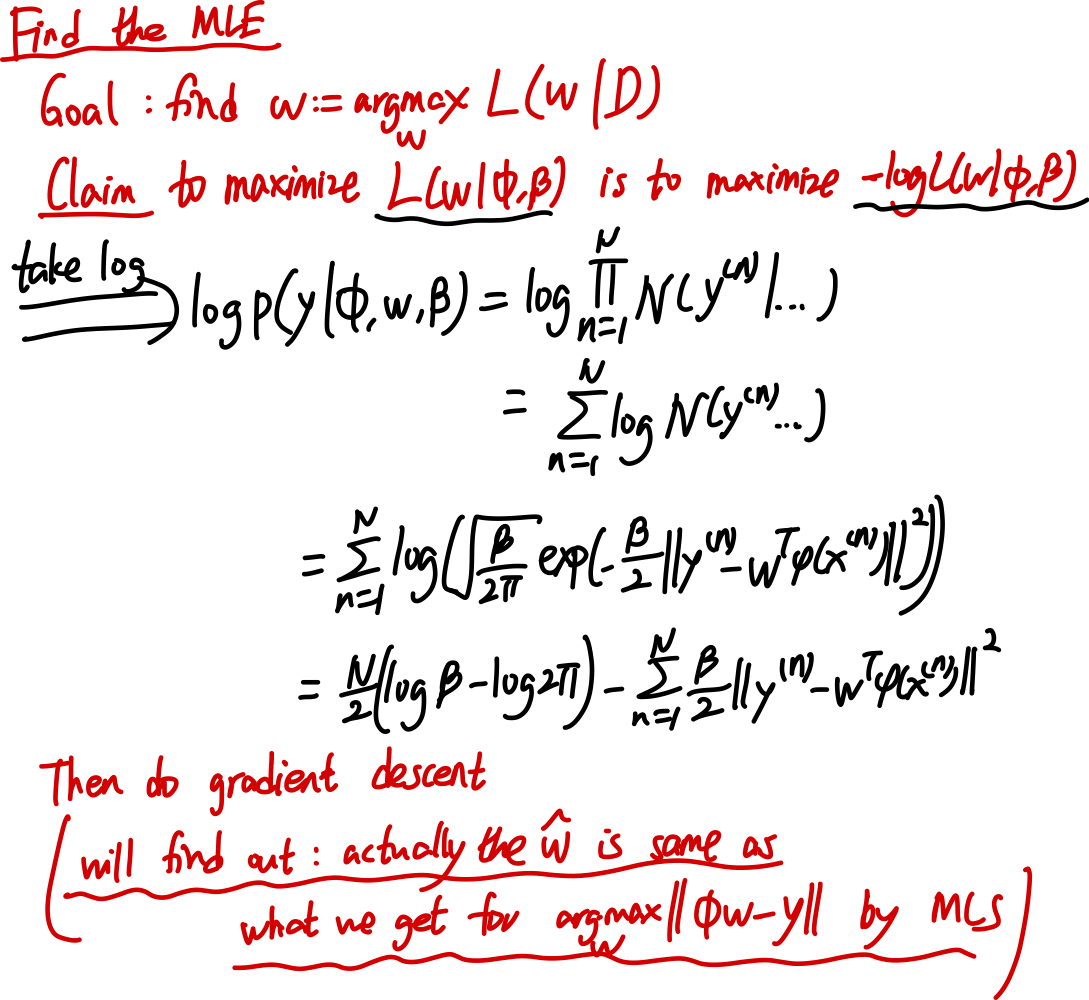
image-20250123180955714

locally weighted linear regression

image-20250123193833909