
logistic regression
logistic regression 是一种二分类算法,idea: 用一个 hyperplane 来分割整个空间
比如我们的 features 数量为 ,那么 (每个 axis 表示一个 feature) 中我们假设存在这样一个 hyerplane defined by weights 即 weights vector,这个其表达式为: $$

在这个模型中,我们并不 deterministic 地 predict,而是 probabilistically.
我们 recall sigmoid function: $$
modeling: output as a probability function of
我们使用这个平面作为概率为 1/2 的分界线, 配合 logistic 函数 来对输出进行建模. 这个输出是一个 source 为 的函数, 表示这个点 的 是 1 的概率和 是 0 的概率,即一个概率密度函数. $$
我们发现这个函数也可以写为: $$
Note: 这里的概率并不是 prior 的,而是我们以 为参数自己定义出来的: 给定一组 features , 它对应的 class 是 0 以及 是 1 的概率.
意思是,我们想要说一个点是 0 / 1 的概率是多少,就能说是多少,这是我们自己通过改变参数 而建模出来的,和真实值本身没有关系。
即,我们假定的是:在这个 hyperplane 上的点, 其得到的属于 class 0, 1 的概率都是 . 因为 $$ **而上面的点, 我们声称它是 1 的概率更大, 下面的点我们声称它是 0 的概率更大(**具体数值根据 input 可计算).
using likelihood function to evaluate "how accurate is our output"
因而完全可能出现的情况: 比如一共有三个点, 一个属于 class 0, 我们却说它是 0 的概率是 , 而另两个属于 class 1, 我们却说它是 1 的概率是 . 这种情况就说明我们的参数设置有问题, 不能很好地反映样本.
我们想要足够好的参数, 使得我们对每个点 [ 作为 input] 得到的 [概率密度函数 作为 output] 的描述是尽可能准确的. 比如这个点实际的 , 而我们的 得到的 为 [ , ].
因而我们需要评判这个输出的结果有多准确并针对 进行优化,需要使用 likelihood function:这是一个 表示在我们给定的数据集 上,我们这个概率描述的输出有多可信。这是一个关于 的函数: $(x^{(n)}, y^{(n)})p(y^{(n)}\mid x,w)x^{{(n)}}y^{(n)}$ 的概率",希望这个值越高越好.
从而: $x^{(n)}y^{(n)}$ 的概率] 的乘积最大, 越接近 1 越好.
比如如果 , , , 而我们的模型得到 "", ", , 那么我们得到的 就等于 0.98 x 0.97 x 0.99=0.941,说明模型很好.
因而,我们的 objective function 就是 log likelihood, 即 $$
minimizing neg log likelihood function: 计算梯度
我们回忆: linear model with stochastic noise 中, 每个 input 对应的预测结果也是一个 distribution of corresponding to it. 只不过在该模型中, 我们是假定 noise 遵守一定 prior 的分布规律 (比如正态分布), 而固定住方差用参数 表示分布中心的不同, 从而通过 minimizing neg log likelihood function 的方式修改 。得到最符合现有样本的分布规律,从而确定从 input 到 output [distribution of ] 的映射模型.
而这里 logistic regression 也类似,只不过这里我们不使用具有先验分布的 noise,而是完全通过 来 encode predicted distribution of , 并同样通过 minimizing neg log likelihood function 的方式修改 以获得最符合现有样本的分布规律, 从而确定从 input 到 output [distribution of ] 的映射模型.
区别是, linear regression 中, 我们需要 output 为一个 distribution function 是因为有噪声的存在, 因而 linear model 被变为了一个 stochastic model; 而 logistic regression 中, 我们是主动构建了 probablistic model.
Note: linear regression with Gaussian noise 中的 output random variable 服从的是 Gaussian distribution, 而 logistic regression 中 output random variable 服从的是 Bernoulli distribution.
现在我们计算一下 gradient:
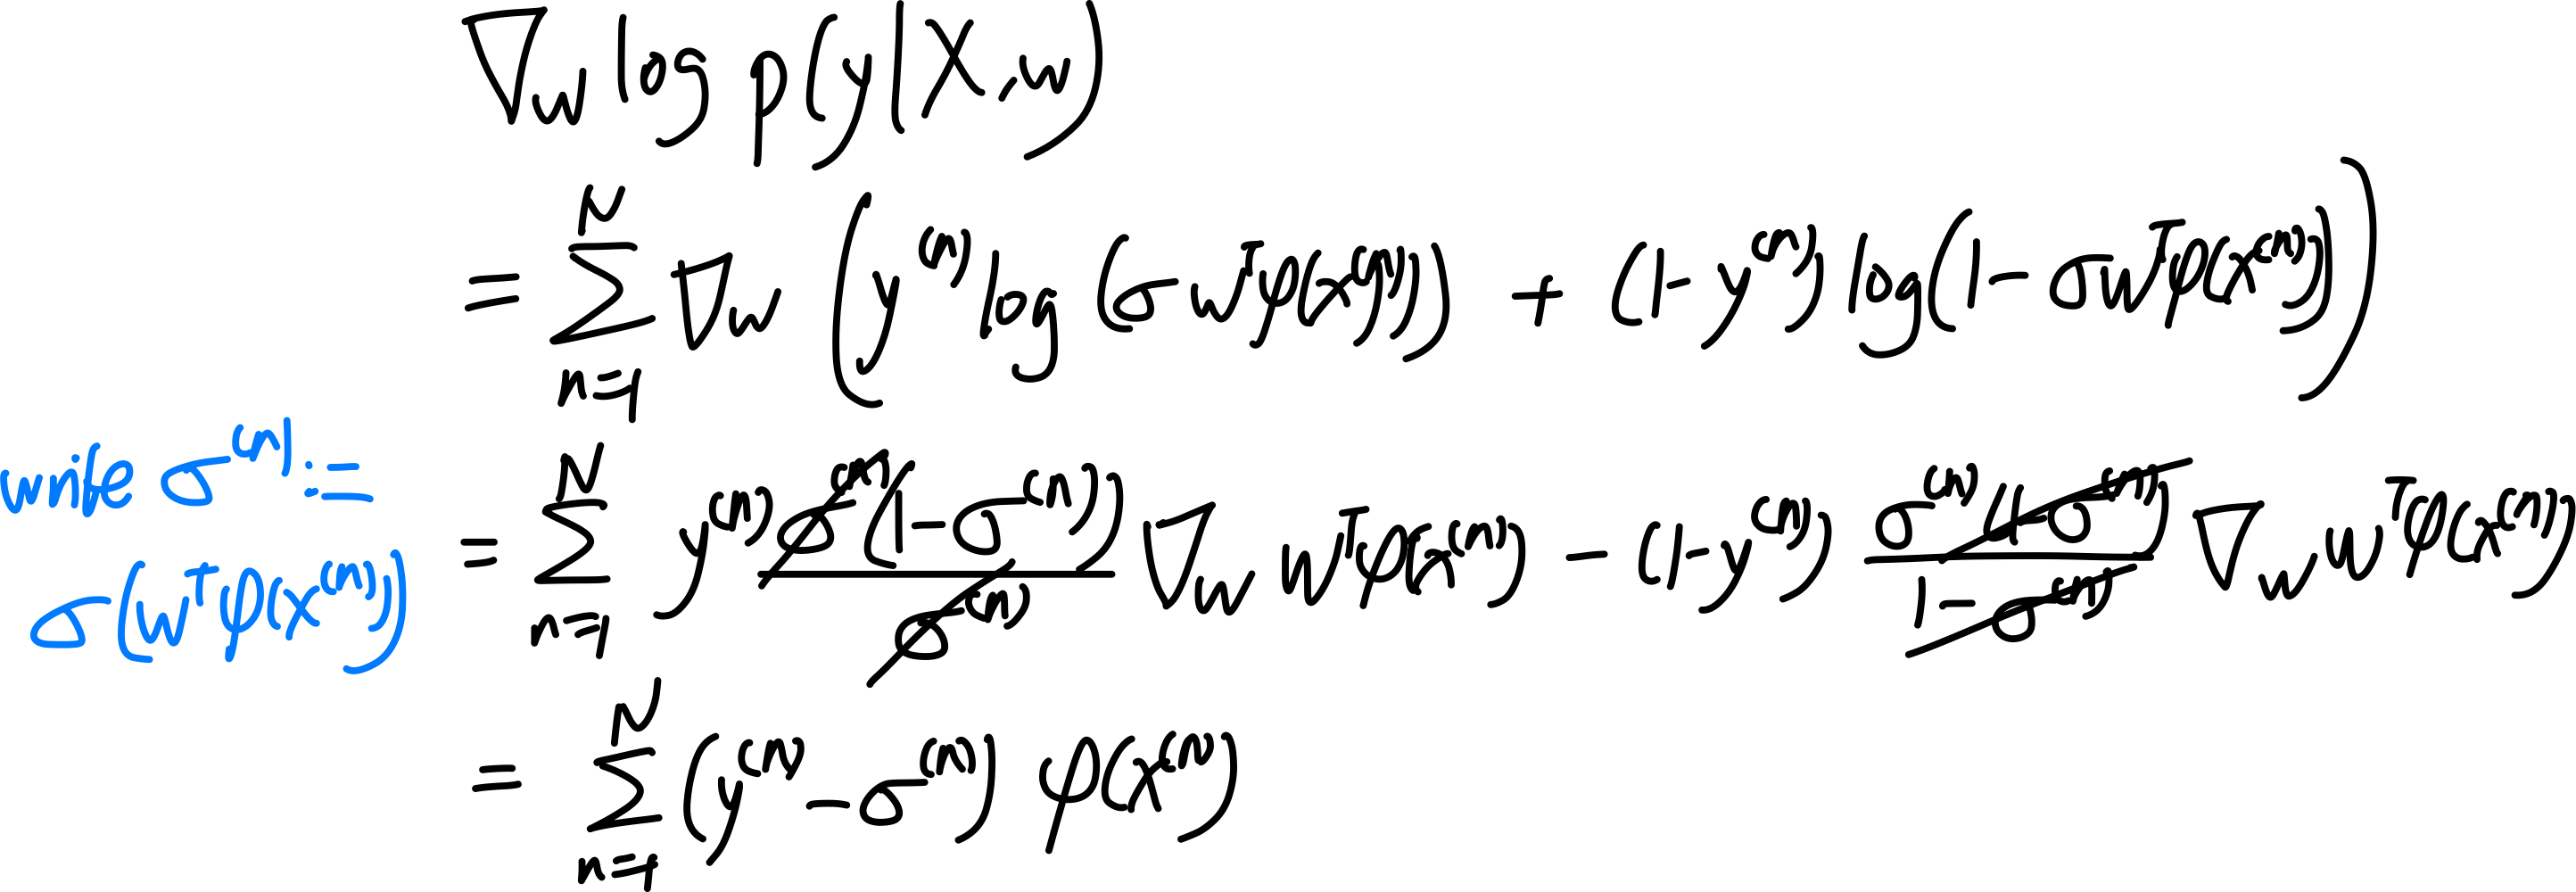
因而: $h$ 中每一项施加了一个 sigmoid 函数就好.**
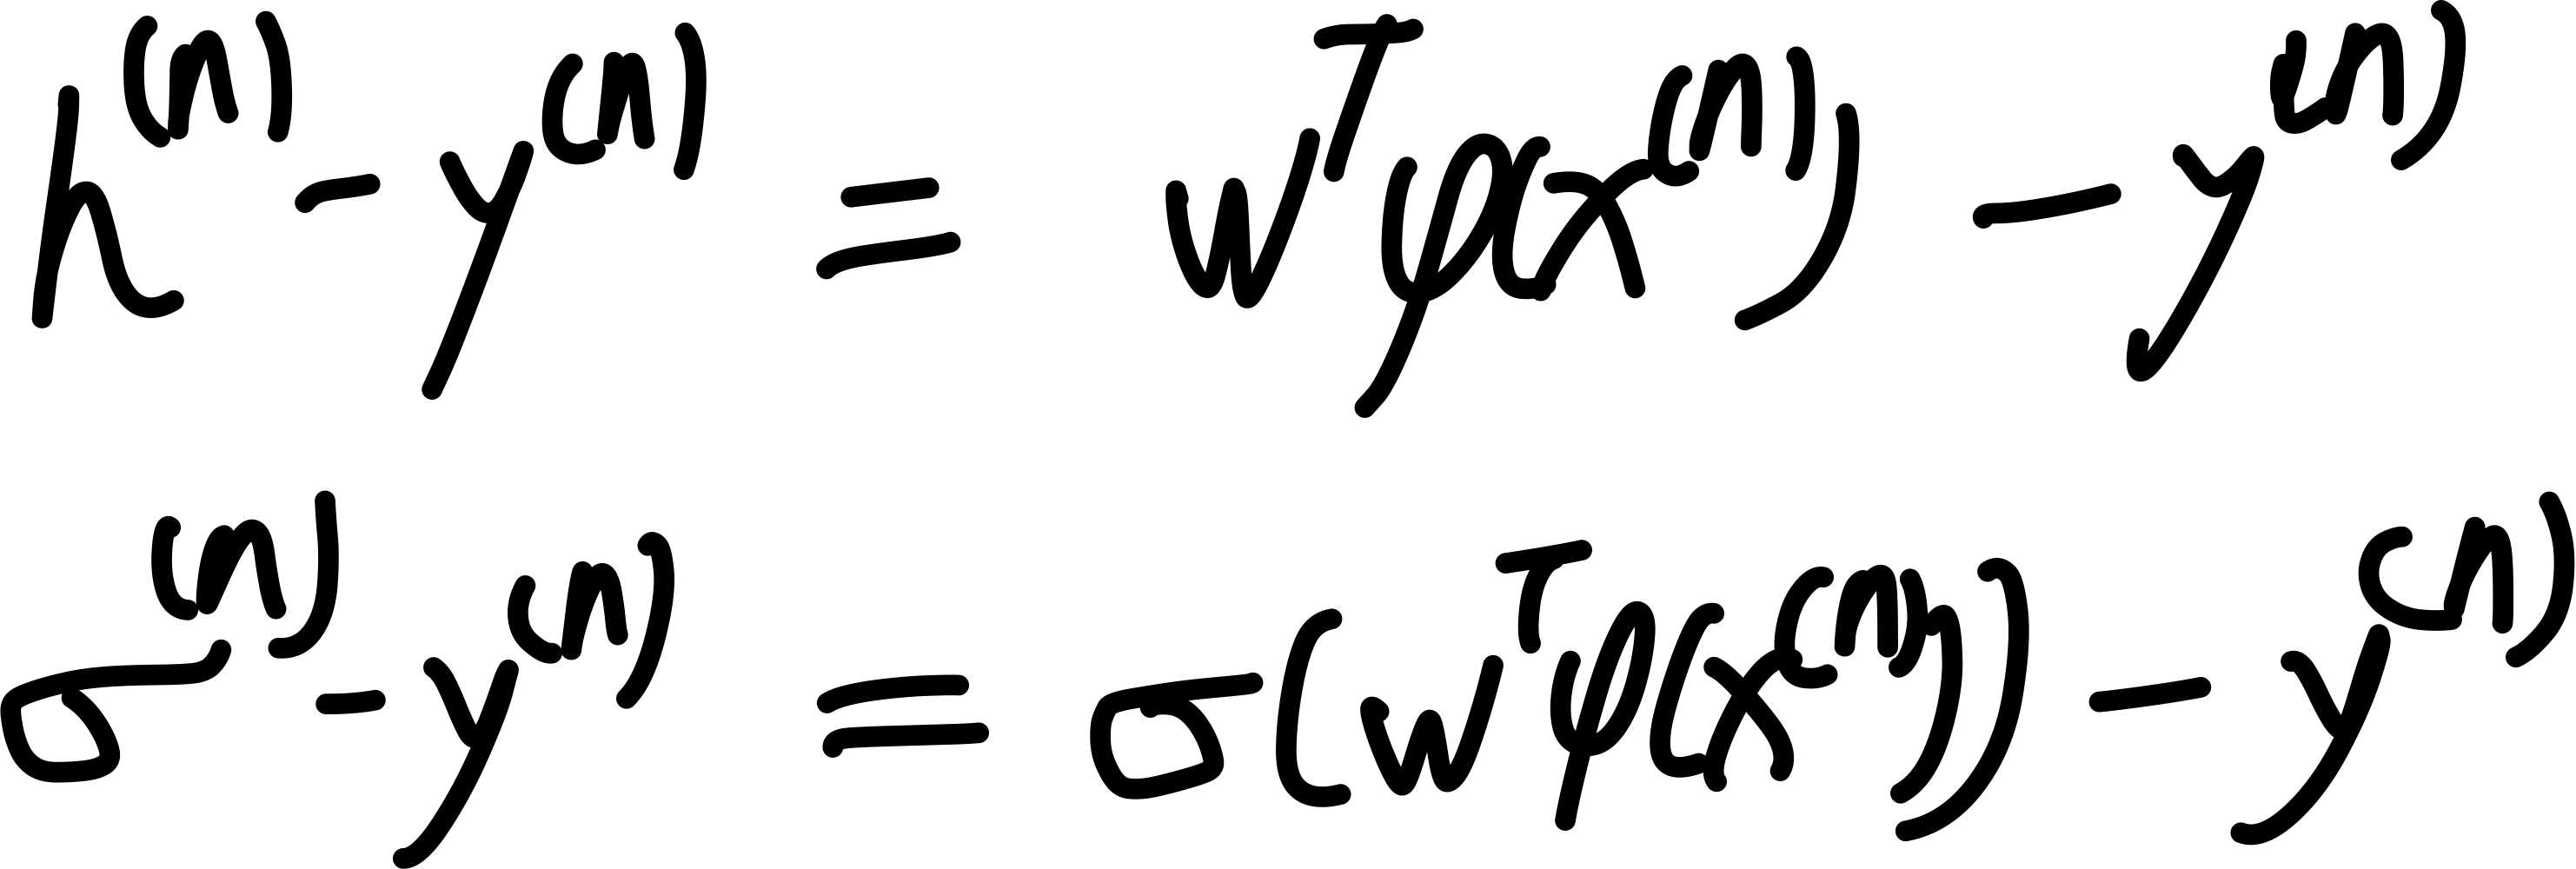
使用 Newton's method 来优化 logistic regression
我们下面讲一个优化方法. newton 法是寻找一个函数的 root 的数值方法.
情况:
为了寻找 使得 , 牛顿法迭代更新: $$ 推导也很简洁, 我们使用一阶泰勒近似:
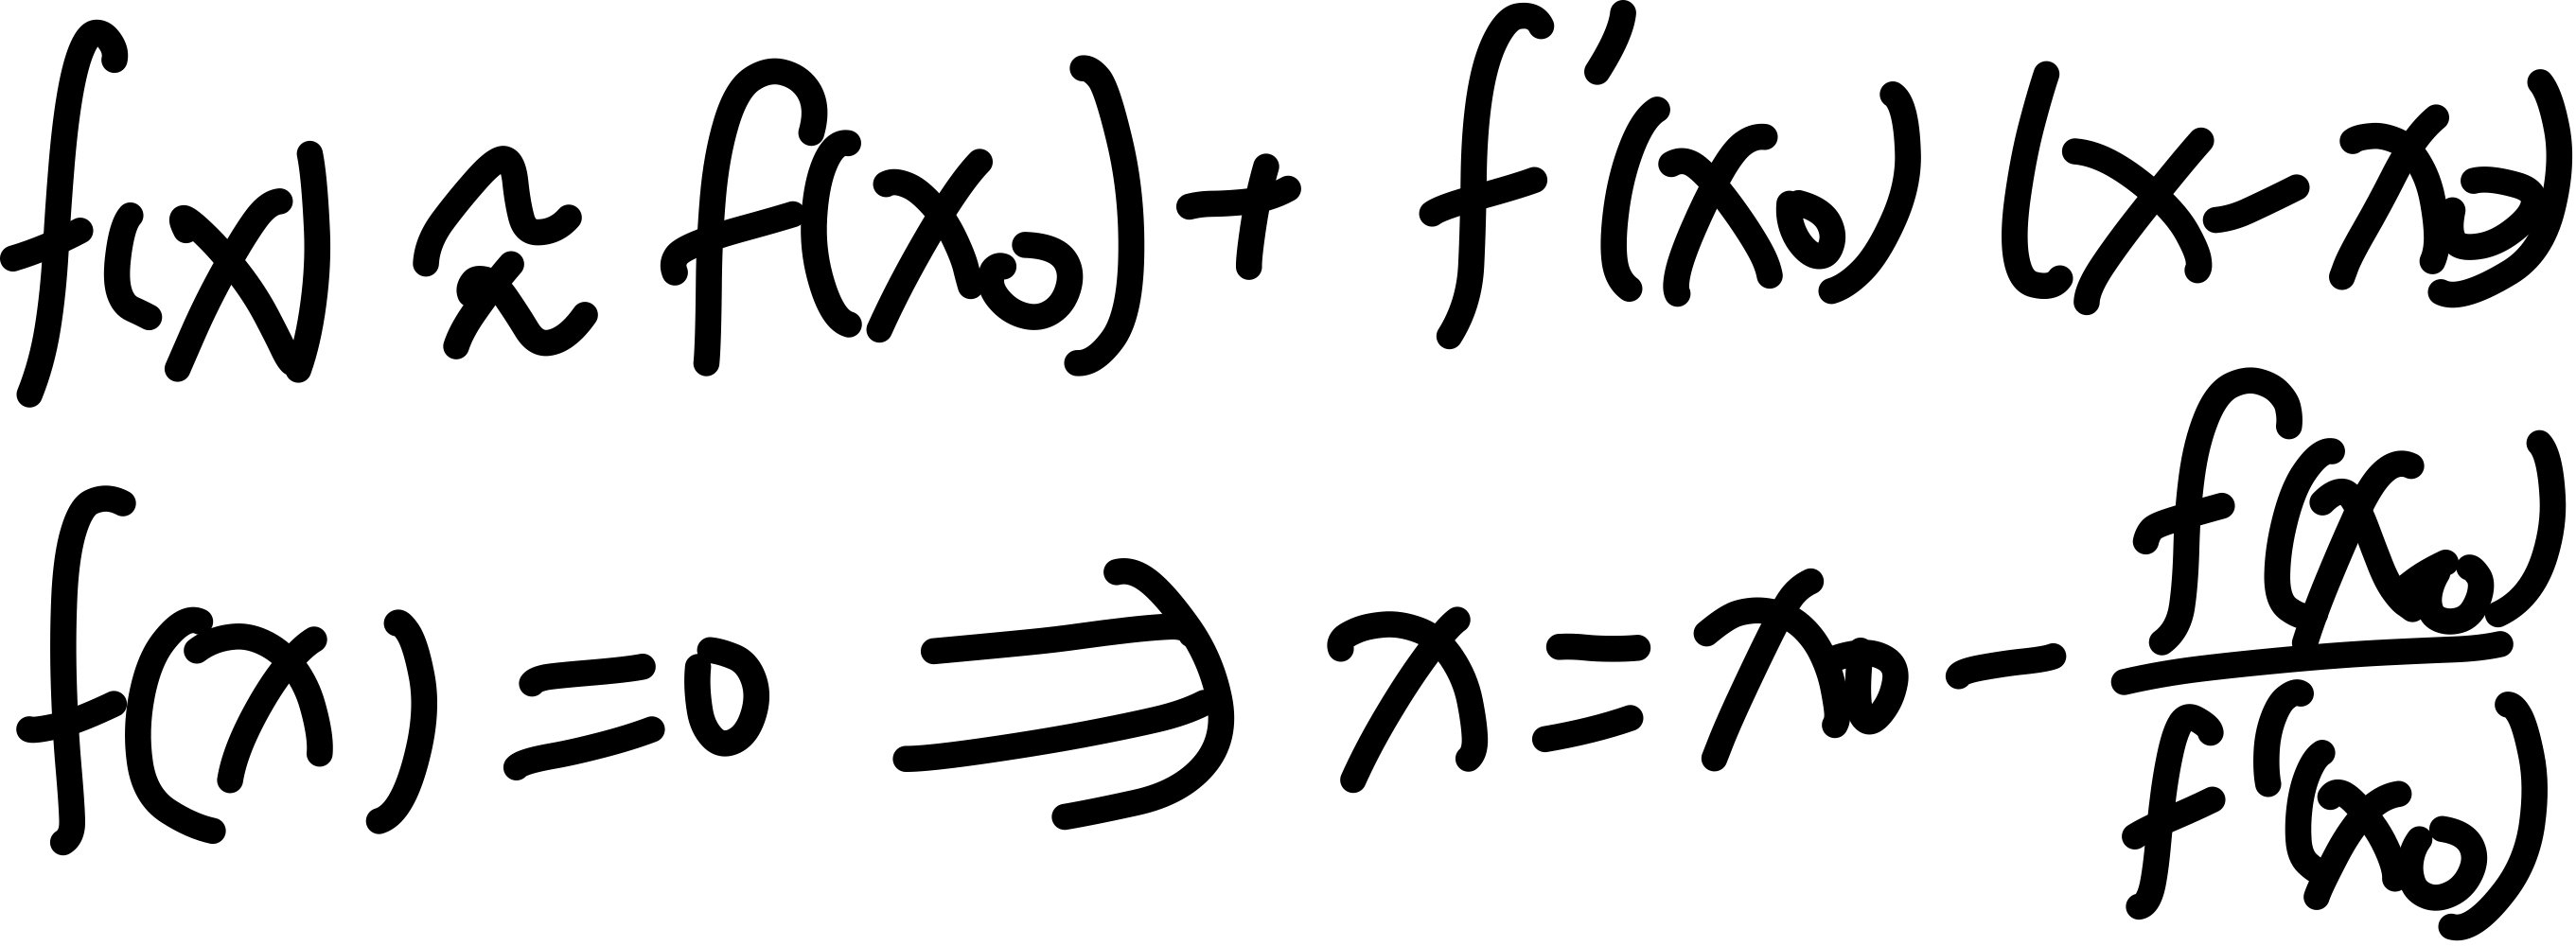
看起来一步就出了, 但是我们仍要进行迭代, 因为这是一阶泰勒近似, 后面还有余项. 迭代就是不停地求出一阶近似结果.
Newton's method in optimization: 求梯度零点
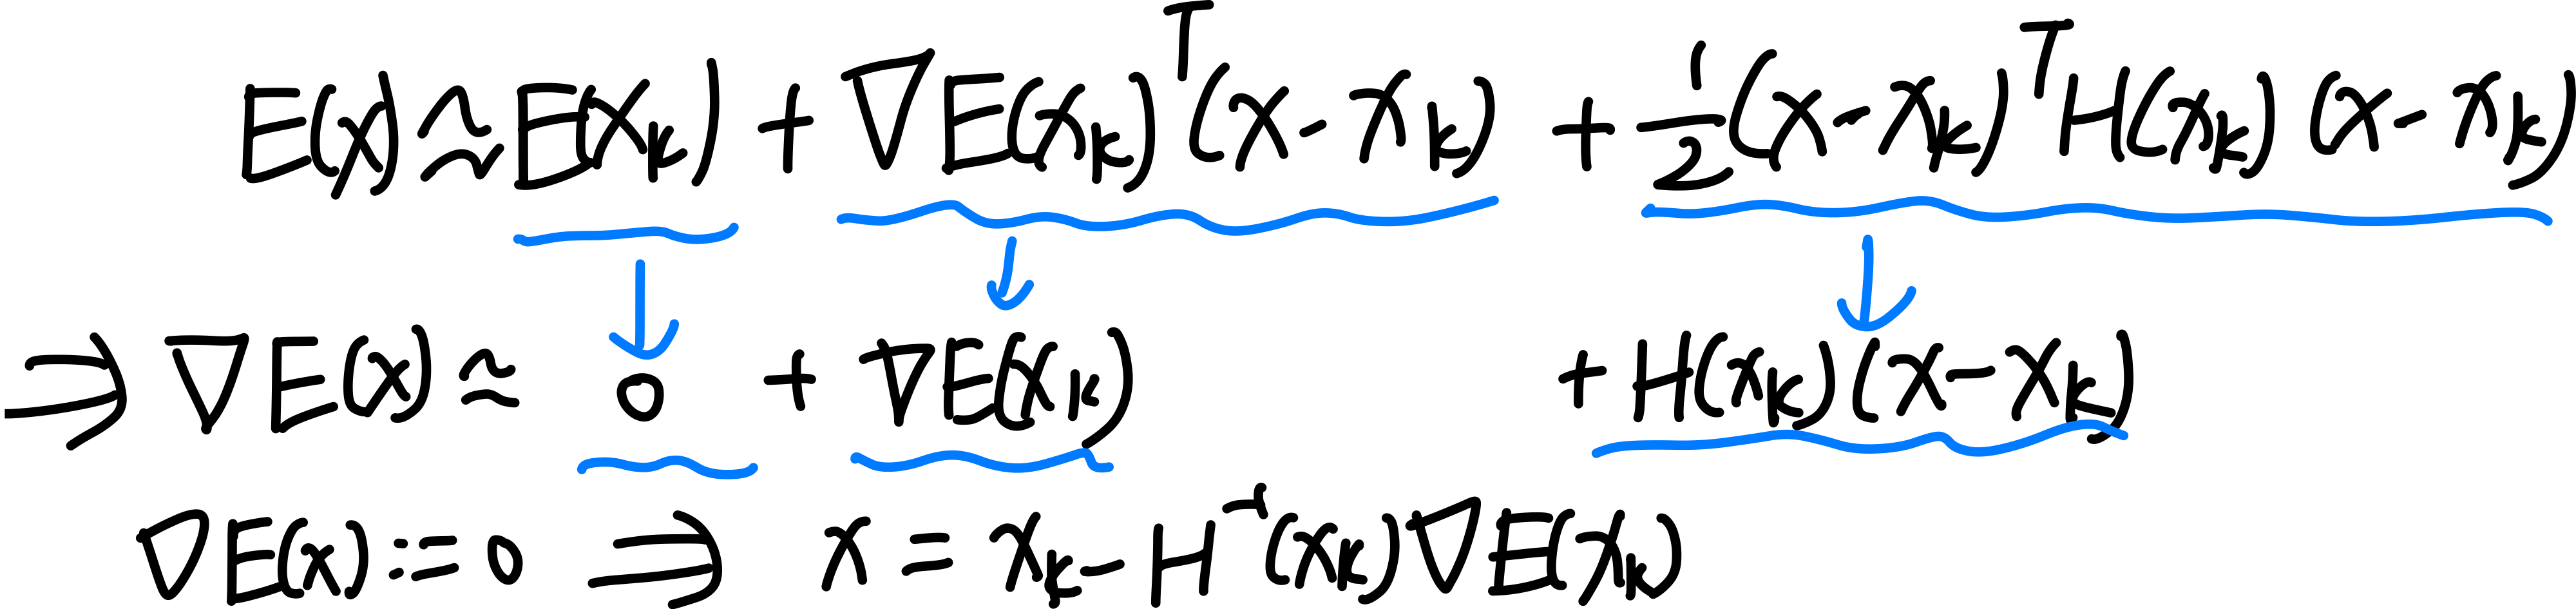
我们对于 , 想要求其 stationary point, 即 处, 我们可以令 , 然后使用 Newton's method 求出 的零点. 因而这属于 second-order method. 它要求一个函数是 的. (严格而言, 据我们在分析课所知, 因为它的推导使用的是二阶泰勒近似).
情况: $$
推导
Note: for linear regression, Hessian 为 .
和 gradient descent 的对比
梯度下降(Gradient Descent, GD)和牛顿法(Newton's Method)都是优化算法,它们各有优缺点,适用于不同的场景。尽管梯度下降是更常见的方法,但牛顿法仍然有其独特的优势,因此仍然被使用。
- 收敛速度
- 梯度下降: 使用一阶导数(梯度)来更新参数,通常采用固定或自适应的步长(学习率)。它的收敛速度依赖于学习率的选择,可能需要较多的迭代才能接近最优解。
- 牛顿法: 使用二阶导数(Hessian 矩阵)来调整步长,可以在二次可微的情况下实现 二阶收敛,即每一步可以更接近最优解,因此通常比梯度下降收敛得更快。
- 步长的选择
- 梯度下降: 需要手动调整学习率,选择不当可能导致收敛速度慢或震荡,甚至不收敛。
- 牛顿法: 由于利用了二阶导数,能更智能地选择步长,不需要额外调节学习率,在某些情况下更加稳定。
- 计算成本
- 梯度下降: 计算梯度的成本相对较低,尤其适用于高维度的大规模优化问题(如深度学习)。
- 牛顿法: 计算二阶 Hessian 矩阵及其逆矩阵的成本较高,尤其是在高维情况下,可能会非常耗费计算资源。
- 适用场景
- 梯度下降: 适用于大规模优化问题,特别是数据维度很高的情况下(如机器学习、深度学习)。
- 牛顿法: 适用于小规模、高精度的优化问题,如凸优化、数值计算中的非线性方程求解。
- 逃离鞍点
- 梯度下降: 可能会卡在鞍点或局部极小值。
- 牛顿法: 由于 Hessian 矩阵的信息,能更好地区分局部极小值和鞍点,有助于避免停留在鞍点。
梯度下降在大规模优化问题(如神经网络训练)中更受青睐,牛顿法在需要高精度求解、二阶信息易于计算的情况下(如凸优化)仍然有优势。因此,在不同的应用场景下,我们可能会选择不同的优化方法,甚至结合两者(如拟牛顿法 Quasi-Newton Methods,如 BFGS 算法)。
Applying Newton's method on logistic regression
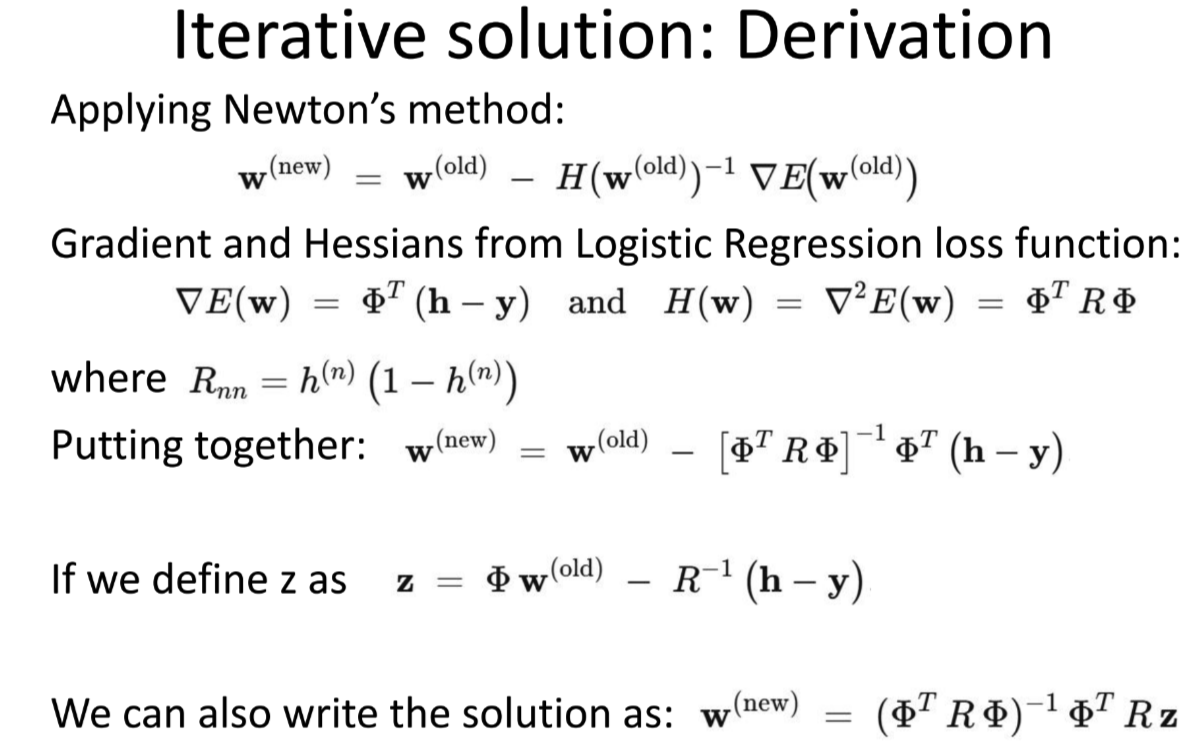
我们在 linear regression 中可以解出 closed-form sol. 但是, logistic regression 是 non-linear 的, 不存在 closed form sol, 所以我们需要通过迭代方法,比如迭代使用 Newton's method 来获得 optimal sol.
这个过程叫做 iteratively reweighted least squares.
推导 sketch:
Softmax regression: multiclass logistic
先前我们的 logistic regression:

现在考虑 multiclass, 的 possible values 是
我们 set:

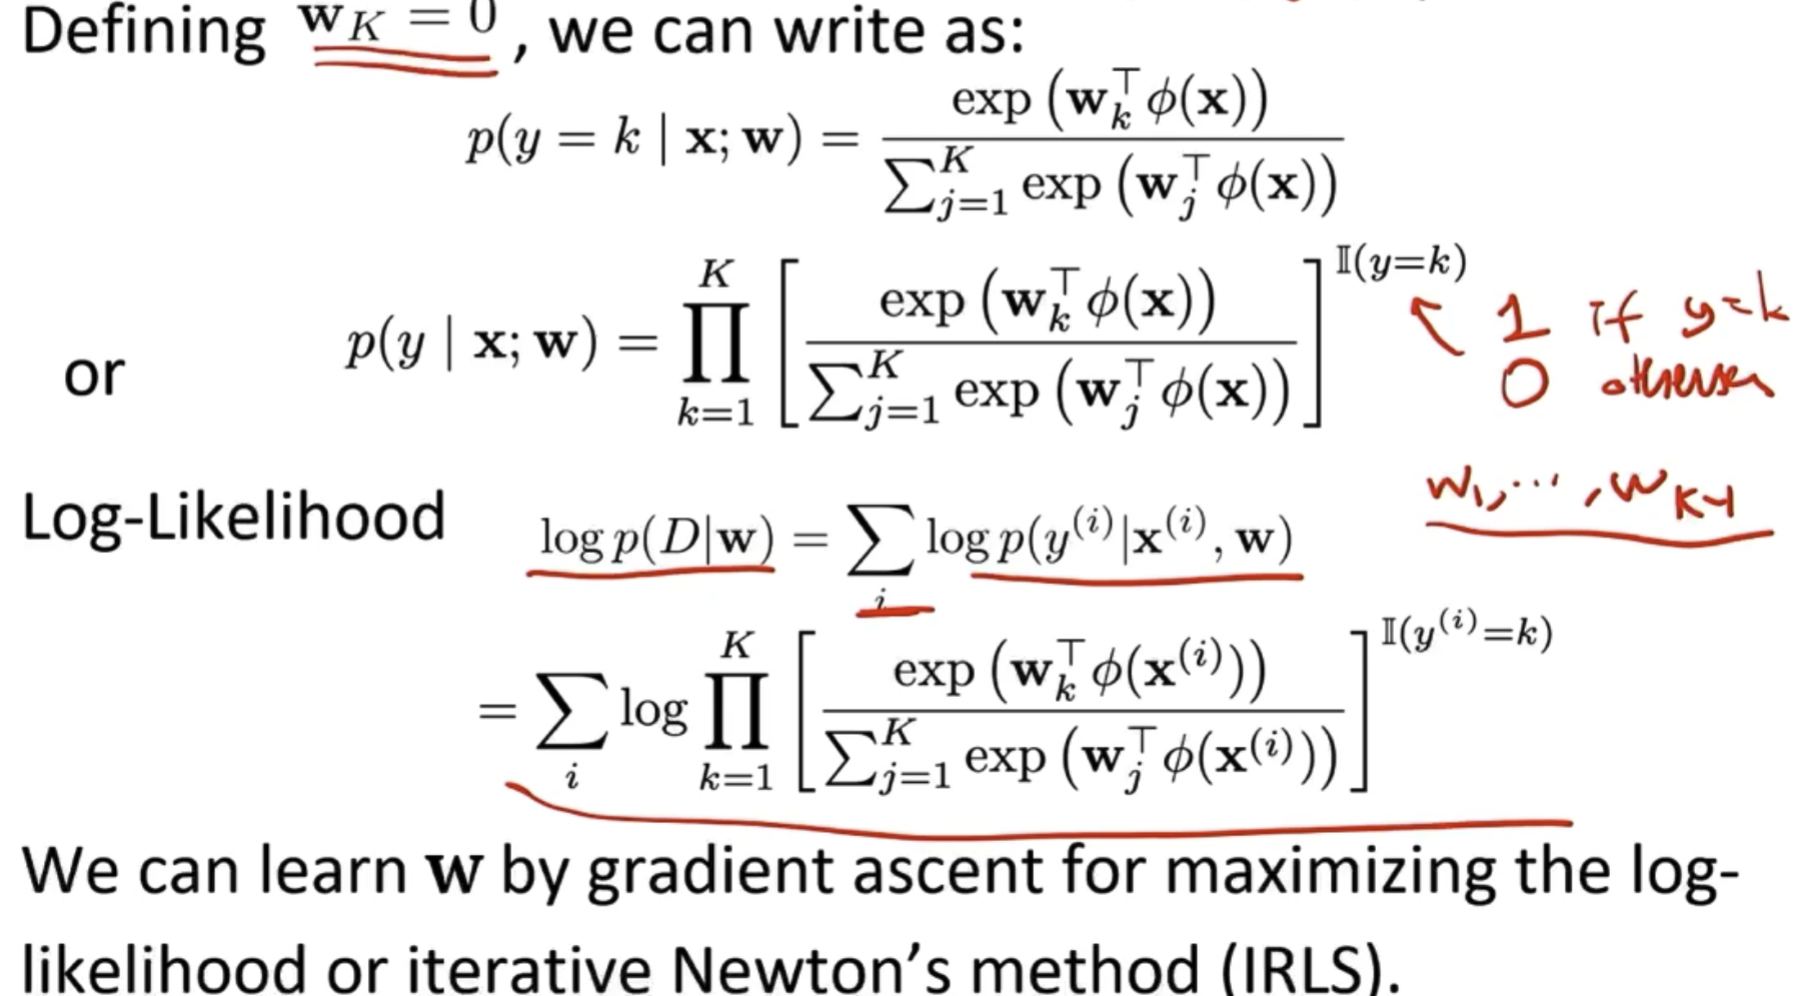
setting the last weight vector to 0 vector
我们采取的策略是: 分配 个 weight vector, 再用它们分别和 input features 的 dot product, 即 logit, 取 exponential 作为这个 class 在这个 上的得分. 最后这个 "y = this class" 的条件概率被建模为: 这个 class 的得分 / 总得分.
注意到: 有 个 classes, 但是我们只分配 个 weight vectors, 获得了 个 logit, 这是因为为了维持这个条件概率函数建模的 well-definedness (符合定义的条件概率函数, 所有 classes 的概率和为 1), 我们必须对于最后一个 class, 固定地用 (1-前面 classes 的条件概率) 这个剩余值来建模, 即设置 恒定.
这个做法是没有问题的, 因为经过前面 classes 的 logit 的作用, 这个 weight 为 0 的 class 的得分会自动适应, 间接地被学习到。(不过,只有最后一个 class 可以这么做,如果设置两个这样的 weight vector 为 0 的 classes, 那么它们就会自动平分剩余的条件概率, 从而这两个 classes 的条件概率永远相等.)
注意:
Softmax 的 weight vector 和 hyperplane 的关系
在 Softmax 回归中,假设我们有 个类别,每个类别 对应一个权重向量
类别 (k) 的得分为: $$
类别的预测概率由 Softmax 函数给出: $$
决策边界的定义:在 Softmax 回归中,类别 (k) 和类别 (j) 的决策边界是由以下条件确定的: $$
单个权重向量 的意义: 定义了类别 的特征偏好, 看作这一类别的“吸引中心”,在决策时决定 离类别 的相对距离。Softmax 回归的类别对之间一共有 条决策边界:每两个类别 k 和 j 的决策边界是一个超平面,该超平面的法向量是 ,而不是单个 ,一个输入被分配到距离最近的类别。
log-likelihood objective function of softmax regression
KNN(K-nerest neighbors)
这是一个比起 logstic regression, 更加简单的分类算法.
**它并不进行 learning!!**而是直接把 training set 原封不动拿来作为参照
而是对于每个 query example,
- 找到 个 training set 中和它最近的点, 这个集合标记为
- 而后, predict 结果为它的 中的众数 . 即相邻的 training 点中最多的从属类.
Note: 通过 adapt 这个预测公式, 我们也可以应用它到 regression 上。
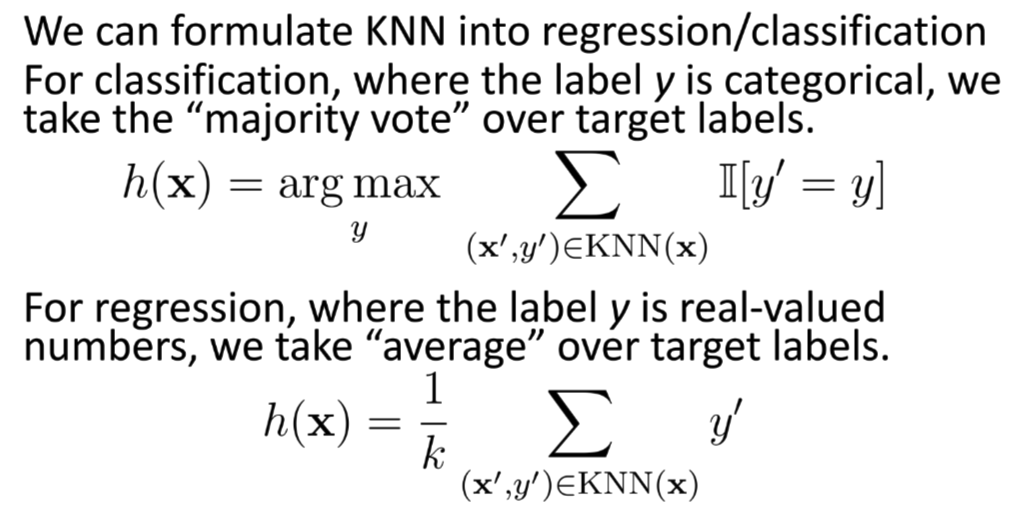
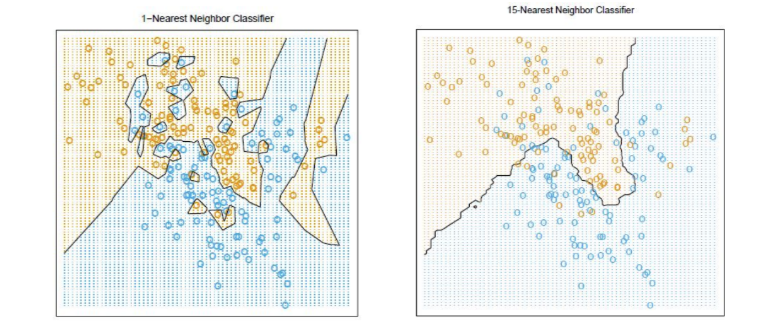
hyper parameters: ( for which Metric)
- 更大的 可以获得更加 smooth 的 decision boundary.
- distance metric 的选择也很重要. (which ?)
除了 hyperparameters 之外, training set size 也重要.
更大的 (training set size) 可以提高 performance.
ESL 13.3 定理: 当 时, 1-NN 分类器的 error 不会超过 optimal error 的两倍
Effectiveness analysis
KNN 的优点是简洁,灵活,对于低维度 input 高效
缺点是 expansive,对高维度 input 并不高效(都太远了),以及 not robust to irrelevant features. 容易收到 noise 影响。